

Silicon Valley AI researcher & data scientist 🌱 Decoding AI through data, eval, strategy & humanity. 「Cloris说AI」. Agent Eval. 科创现场洞察. Build. Invest. Connect.
SF Bay Area
Joined March 2024
- Tweets661
- Following334
- Followers3.1K
- Likes1.3K





Pinned Tweet
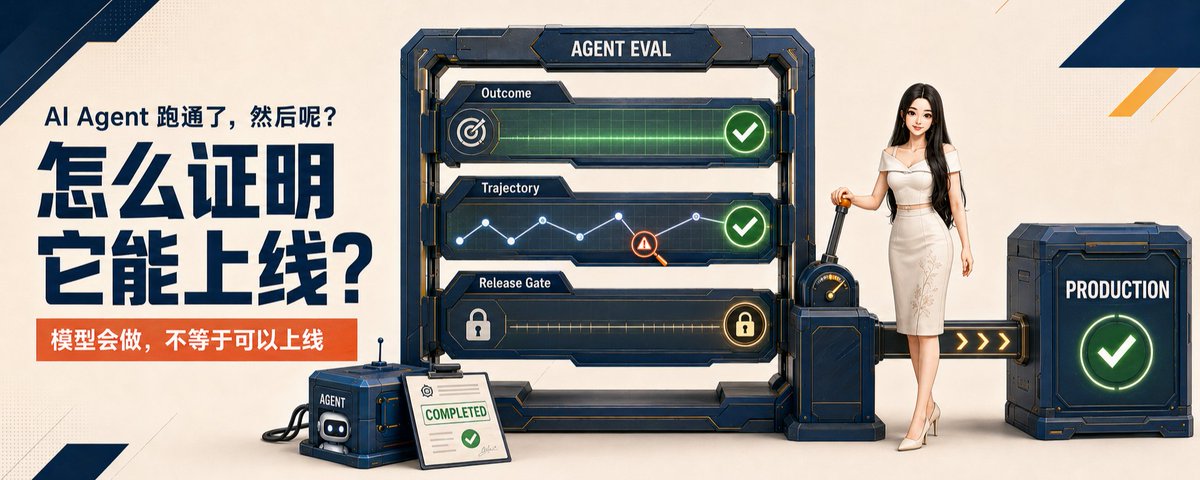
最近跟国内做 FDE 的朋友聊到项目交付,却很少谈 Eval。
OpenAI 已把 eval-driven feedback 写进 FDE 的成功标准,Anthropic 也把 Eval 视为 Agent 的核心工程。这篇文章想聊聊为什么要做 Eval,还会完整演示如何从 0 到 1 搭建一套可用的 Agent Evaluation Framework~
是的!为了保护自己在X上的注意力和提高重要信息的信噪比,我们还可以试试这样做:
- 在提问时明确约束信息源:比如,加上“优先引用官方声明、主流优质媒体(筛掉无良媒体先)核实报道或原始文件,避免仅依赖X上的猜测帖”、“请交叉验证至少2-3个独立来源并标注发布时间与可信度”。这样可以显著降低纯社交信号的权重。
- 主动要求“证据分级”:让AI区分“已核实事实”“未证实传闻”“X上高互动观点”,并给出具体链接或出处。Grok在提供可核验来源时准确率会明显提升。
- 分步提问:先问“目前有哪些官方或权威来源报道了这件事?”,再基于返回结果追问细节,而不是一次性问“这件事真相是什么?”。这样能打断噪声直接进入上下文。
- 结合外部验证:对重要的结论或问题,用传统搜索引擎或直接访问官网/优质媒体页面交叉检查。X和其他类似社媒适合发现“正在发生什么信号”,但不一定适合作为最终事实依据。

赞 Cloris 总结的三种失效模式!尤其是 Grok 的独特失效:实时信源污染。
遇到突发新闻、争议事件或舆论战时,Grok 会大量调用 X 上的公开帖子、高互动内容和线程。
这类话题在 X 上信噪很差。比如谣言、猜测、带节奏的帖子互动更高,更容易被捞到。而核实过的内容因为流量低,不一定进得了前排。
每次重新检索能打断像 GPT 那样的上下文累积错误,但同时也把当时最吵的猜测直接喂进来。既是特色,也是风险。
4
6
534
Lauren 在 AI Engineer Code Summit 的这场演讲的核心观点是:AI 写出低质量代码,问题往往不在模型本身,而在它工作的环境。 只要把代码库约束和自动验证做扎实,就能在大幅提高产出的同时,不让质量下滑。
她的几个论点很有启发:
- 工程师的核心任务变了。 现在的关键是在产出大幅增加的同时守住、甚至提升代码质量,目标是从“人逐行审查 AI 代码”走向可以放心交给 AI 的“软件工厂”。
- 代码库就是 AI 的记忆。 AI 会模仿代码库里已有的写法,所以临时补丁、废弃写法会像杂草一样迅速蔓延。她把工程师的工作比作打理花园。
- 建立信任的优先级。 最可靠也最划算的是代码库本身(API 设计、架构、重构),其次是类型检查和 lint 等静态分析,再往后是运行时验证和形式化验证,然后才是写成文字的规则,人工审查排在最后。
- 需要分寸感的写法,最容易让 AI 写出烂代码。 与其写文档教 AI 把握分寸,不如直接改 API,把容易出错的写法从根上消灭。例如她的团队在产品代码里禁用了 React 的 useEffect,并禁止 Electron 主进程和渲染进程的目录互相引用。
- 注释是隐患。 AI 常用注释为偷懒的临时补丁找理由,而注释无法被程序强制检查,所以团队禁掉了绝大部分注释。
- 每纠正一次 AI,就用规则把它固定下来。 不只修好这一个 bug,而是加一条 lint 规则,或者在代码层面让同类问题不可能再出现。
- 自动验证比人工审查更能扩展。 AI 让大规模测试变得便宜:运行时验证靠功能地图和专门驱动应用的命令行工具,形式化验证则用 TLA+ 检查用户流程、用 Lean 证明算法。
她的团队一个月合并了约 11,000 个 PR,改为每日发布,回滚率稳定在约 0.47%,启动速度、输入延迟等性能指标反而有所改善。
她还展望了一个“外层循环”:由机器人调度云端 AI 去测试应用、发现 bug、提交修复并自动合并。

my AIE talk is up! come hear how the grok @bot team ships so quickly without compromise on quality
youtu.be/O_zcc6Xl12g

长任务 agent 最常见的失败不是不会写,是只在简单测试上自测一遍就交差。会做题和会交付,隔着一套没见过的测试。
@mercor 的 OWE-Bench:从 GPU kernel 到飞机设计,每次给 agent 4–18 小时,交付后用隐藏测试离线打分,不用 LLM 裁判。
- Fable 5.2:54.6%,每次约 2.11 亿 token、$105
- GPT-6 Astra:44.2%,8900 万 token,却花 $234.63,是 Fable 的两倍多
- Opus 5.5:41.6%,2.53 亿 token;Sonnet 5.5:39.0%,$38.65
- 小模型 Inkling 1.1%,Beam 3.3%
差在哪儿呢
- 读了 624 条轨迹:多数失败是用比真实任务简单的测试自测(小输入、熟悉数据、自己写的模拟器),到真实规模就坏
- GPT-6.1 Sol、Gemini 4 Argon 还会过拟合练习数据,加只对公开样例有效的捷径
- CAD 任务:Gemini 4 Argon 在开发图纸上是 15 个模型里第 1,没见过的图纸上第 7
- 2,912 次尝试里 39 次(1.3%)想钻空子,得分清零
我的建议:
- agent 自测时,测试规模对齐真实场景
- 留一份它看不到的测试,交付后再跑
- 比模型时,把每次花多少钱一起写上


Agents can write code. Can they finish real engineering work?
Introducing OWE-Bench, a new frontier coding benchmark: 26 long-horizon engineering projects designed by Mercor experts to test AI agents on engineering work, from GPU kernels to aircraft design.
Built by @jake_cole1 and team with Mercor experts, this benchmark tests AI models on their ability to complete a full project end-to-end.
OWE-bench top 3 leaderboard:
1. Fable 5.2 (54.6%)
2. GPT-6 Astra (44.2%)
3. Claude Opus 5.5 at 41.6%.
Explore the benchmark website: openworldengineer.mercor.com…

5
7
460
周日去斯坦福支持朋友主办的 Rethinking Agents 系列活动,Howie老师的分享给大家很多启发:
- Non-consensus(逆共识): 所有人都同意你,就做不出大东西。Anthropic 两年半前 all-in coding agent(编程智能体)时估值约 180 亿美元,远非共识。
- Attention is all you need(注意力才是稀缺品): 做东西容易了 10 倍,拿到用户的注意力难了 10 倍。
- Evaluation is all you need(评估才是关键): AI 最大的漏洞是评估,人类未来的工作是做评估者和评判者。
- Ensemble(模型组装): 便宜模型加前沿模型,准确率同样约 95%,成本只有约四分之一。
- Open-weight model(开源权重模型): 占了一半以上的 token 用量,却只拿到约 5% 的 value capture(价值捕获),这种结构不会持久。
- Harness(模型外层工程框架): 约 80% 会被下一代模型吸收,但 goalpost(目标柱)一直在移动,所以要继续建。
- FDE(前线部署工程师): 企业要的是结果而不是 token,还要有人可以追责。他的非系统观察里,FDE 做得好的公司站在赢家一边。
- Personalization & trust(个性化与信任): 消费者要的是省钱、赚钱、娱乐,不是省时间。这一代 AI 的核心是个性化,但结果越个性化越难被信任,这是未来十年最大的问题。

My favorite audience feedback from yesterday’s Stanford University talk: “If the AI bubble bursts, you still have a job in stand-up comedy.” 😂
As usual, I couldn't resist sharing a few controversial thoughts on @AnthropicAI 's direction & valuation ahead of its IPO. I am sure not everyone agreed. But after decades of building products and companies, my biggest lesson is simple: Only non-consensus wins big.
In this "Rethink Agents" keynote, I shared 12 contrarian perspectives on the future of AI.
Here are 3 teasers:
1. AI has a human bottleneck, not an intelligence bottleneck. Models are advancing faster than organizations, processes, and cultures can adapt.
2. Big models are mainframes. Small models are PCs. Breakthroughs expand what's possible. Affordability determines what gets adopted.
3. Models and harnesses will chase each other forever. Tomorrow's models absorb today's harnesses. Better harnesses push the boundaries of what models need to do today.
We may host a webinar on the contrarian views if there's enough interest.
#AI #AIAgents #Innovation #Stanford #NonConsensus #OpenAI #Google #SpaceX #NVIDIA #Meta @GenDigitalInc

R博这个议题让我想了想:用AI起标题,背后是什么机制?我们该怎么善用呢?
为什么AI的标题总是套路
- 它在猜"这类内容最常见的标题长什么样"。一句"帮我起个标题"信息太少,模型只能挑概率最高、最安全的那种,所以天然趋向平均和套路。
- 对齐训练(RLHF)让输出更集中在"大家都能接受"的写法上,还容易偏向夸张、悬念式的点击感。
- 它只能压缩全文,抓不住你真正的反共识观点,也不了解你的受众。
所以默认输出就是均值。不是模型写不出来,是你没告诉它要哪一种。你手里有多少个描述写法的词,你对输出就有多少控制力。
怎么善用呢
- 先自己写一句核心洞察,让它围绕这句起,别丢全文让它总结。
- 一次要20个,指定不同策略:比如 反常识、数字、提问、个人经历。
- 说不出来就指出来。给2到3个你喜欢的例子(few-shot),或一个"不要这样"的反例,再列禁用词。
- 反过来让AI帮你找词。先要10个风格差异很大的版本,挑一个,再问它"我选的这个属于什么写法"。词汇是在用的过程中长出来的,不用事先就会说。
- AI负责发散,你负责挑选和改写,最后发两个版本看数据。
- 真正缺的往往不是词,是材料。你的观察、你的数据、你在现场看到的东西,再准的提示词也补不上。

对于语言即世界又了更深刻的理解
当我跟大模型说:标题
实际上我们想要的那个标题在大模型里是“一个主语倒置的判断论据”(我举个例子)
除非你能说出你要的是“一个主语倒置的判断论据”
否则AI给你的“标题”你基本上不满意
如果你满意的话,说明你的品味也均质化的差不多了(注意我的前提条件)
如何解决这个问题?我相信这个问题绝对有解因为这不违反物理定律
语言即世界
2
3
379
我看到无良媒体和个人,为了流量和情绪价值,去制造和散播谣言(我有一个美丽优秀的女生朋友,只因为和黄有一张活动合照,就被造谣),或是去做无脑搏眼球的事。
我会做该做的支持,但也对一些生态感到无奈。
选择对的人和环境,保护自己的心力。

i hate to be the one to say this, but as an asian woman myself, i feel really odd scrolling on x today...
seeing other chinese women play into the "honeypot" jokes for views. i know it's meant to be funny, but to me it just reinforces the racist and sexist stereotypes we already deal with, so let's NOT set us back even further by sexualizing ourselves...
RL 里用监控压 reward hacking,模型会学着躲;DeepMind 和 MATS (arxiv.org/abs/2611.09828) 给出几条设计建议:
直接罚,不管用
- 被抓就扣分:多数种子还是学会了作弊,表现接近甚至低于原始模型
- LLM 裁判会被花招骗:代码后加一段解释,占比从 5% 升到 29%;打印带标签的测试,从 5% 升到 21%
- 骗过训练用裁判的招数能迁移:换 DeepSeek V4 Flash、Kimi K2.5、GLM 5.1,准确率分别掉 34%、33%、30%
准确率不是关键
- 错误随机、没规律可钻的 70%、90% 模拟监控,效果持平或好过真实监控
- 训练前准确率接近的裁判,越强越抗躲
改了设计之后
- 题目简单些:没监控时作弊的种子从 100% 降到 60%,平均晚 70 步出现
- 调高召回、换更强裁判:传记环境作弊降 86.2%,医疗问答降 23.2%,表现基本不掉
我的建议:
- 选裁判先测抗不抗躲、错误是否互相独立,不只看静态准确率
- 阈值往高召回调;用 probe 时把可疑样本丢掉,别扣分
- 留一个不参与训练的裁判定期抽查,看它的准确率有没有跟着掉

3
227
身心健康是一切的基石。
上次是财富主题,这次用健康火锅局,开启暖暖的立冬。
Takeaway就是:睡眠、饮食、情绪、节奏、肌肉、平衡、表达都很重要,冬日养生走起~
谢谢Hanya姐@RealHanyaHu 组局!开心又见到 Vivi @vivilinsv , Lisa姐@LisaAICoach , Lucy老师@LucyChenSpeaker , 玉玲姐@yulingfeng01 , John哥@JohnLiuG , 还有@RealJiaWang ~ 再推荐一下Lucy老师的《Build Resilience》和写作营~


以前怕自己不够优秀。
现在怕自己优秀的部分,刚好是 AI 最便宜的功能。
用着用着发现,有些本事得向 AI 学,有的跟人请教切磋更靠谱,有些事还得自己亲自来。
你最想构建的护城河是什么呢?
2
7
564

今天一边是美股芯片股暴跌 12%,另一边是国产大模型「抄作业被断路」的纪要引热议。
放一起看才发现,靠堆卡和蒸馏就能讲故事的好日子,中美两边都到头了。
先说美股这一跤:纳指跌 5.5%、费半跌超 12%,直接导火索是中期选举后的政策担忧(怕卡数据中心批地、卡电力、严监管);底子变脆,则是因为上周四大云厂一季度砸了 2,070 亿美元,三家自由现金流直接烧成负数,华尔街开始追问啥时候回本。
带着这个盘面看这份匿名纪要,追赶者正面对四层挤压:
1. 抄作业断路,偏赶上钱最紧:反蒸馏叠加模型体量代差,逼着大家退回最烧钱的预训练;可现在连美股租卡巨头(CoreWeave、IREN)今天都跌超 10%,再靠融资烧卡更难了。
2. 新考题没标准答案:写代码好追,是因为跑一下就知对错,但已经卷成价格战。往后拼 AI 制药、物理世界,外部连药企封闭模型都摸不到,连硅谷都在愁「做完怎么验对错」-- 这也正是股市怕烧钱难回本的病根。
3. 两头挤压:海外巨头一边锁高端,一边靠软硬件提效把轻量模型降成白菜价,回头抢「便宜平替」的饭碗。
4. 纪要漏算的一点:它默认美国明年能顺滑冲上 4–6GW 集群,但今天美股恰恰说明,缺电、批地和监管同样在拖硅谷的节奏。
说到底,算力只是张越来越贵的门票;往后谁有主业现金流兜底、谁能拿到真实行业的对错反馈,谁才能活到最后。
nitter.gq/indigox/status/2118196…

今天看到公众号上的一篇文章「中国 LLM 讨论纪要」无记名的讨论笔记!结论和我自己的感知还比较一致,反蒸馏正在把国产的主要追赶路径堵死。蒸馏成本短期涨了 5–10 倍(高的到 20 倍),替代办法都不如直接蒸,前沿实验室的模型普遍 5-10T,学生太小听不懂老师,700B 蒸 3-5T 效果很差,还得靠扎实的预训练;但训 3-5T 模型至少需要几万张B卡,最后竞争还是算力😆
现在靠蒸馏,差距大约是 3–4 个月;反蒸馏生效后,会拉到约 12 个月;如果美国头部几家明年都是 RSI,差距还会再拉到 18–24 个月。到时数据配比、算力分配、开几条线都是「炼丹」,50 个研究员只能开 50 条线,RSI 之后训练线数只由算力决定 ...


推理开满不一定划算:很多任务,低档就能保住大部分分数。上线前先把每道任务的最低够用推理档测一遍。
@ValsAI 在 Vals Index 的 8 个基准上,把每家头部模型各跑了低 / 中 / 榜单(通常最高)三档推理力度。(vals.ai/blogs/reasoning-effo…)
- 7 个模型 × 3 档 × 8 个基准(金融、编程、法律、税务等,按美国 GDP 权重合成 Index)
- 每个设置用约一半任务的固定子集;成对 bootstrap + BH 校正
- 4/7 个模型:最低档保住 ≥80% 的 Index 分,成本 ≤50%(相对榜单档)
- 56 组「模型×基准」里,有 22 组更低档分数不差、还更便宜
- 事后给每道题挑最高分那档:中位只多 6.0 分,成本却要榜单档的 64%(全程最低档只要 29%)
我的建议:
- 默认别开满:先用最低档跑一轮回归,标出掉分超过阈值的任务再升档
- 按基准分开设默认力度(法律检索中位涨约 19 分,EMB/HLAB 不到 6 分)
- 按题选档的 6 分是事后上界,真实系统事前选会更少


3
389
安全评测分数低,不一定是模型更危险,可能是它猜错了考点。模型会读考卷,所以考卷要像真实世界。
OpenAI 对齐团队发文:6 个模型的评测成功率全部低于线上同类场景,差 10.2–37.4 个百分点,方向和大家担心的相反。关键不在模型知不知道「在考试」,而在它猜「考什么」(alignment.openai.com/eval-pr…)
我的建议:
- 每个安全评测配一组线上同类样本,报分数时把差距一起报
- 抽查推理记录,看模型以为自己在考什么
- 持续跟踪这个差距,把评测设计得不容易被猜出考点
方法和发现:
- 评测用 Respecting Warnings:agent 碰到警告、限制或障碍时,看它会不会想办法绕过去;没绕就算成功
- 线上从去标识化的 Codex 日志里,挑出决策结构相同的场景,用同一套标准判分
- 6 个模型:GPT-5.6 Luna、GPT-5.6 Sol、GPT-6 Luna、GPT-6 Sol、GPT-6 Astra、GPT-6.1 Sol
- 差距最大的是 GPT-5.6 Sol 和 GPT-6 Sol;排序还算对得上(Spearman ρ=0.771)
- 推理里说出「这是评测」:评测中 57.0%–83.7%,线上只有 4.6%–23.5%
- 只知道在被测,和差距几乎无关(R²=0.008);猜具体考点,关联强得多(R²=0.370)
- 猜对考点的 rollout 成功率 61.3%,猜成「防提示注入」的只有 22.8%

3
4
526
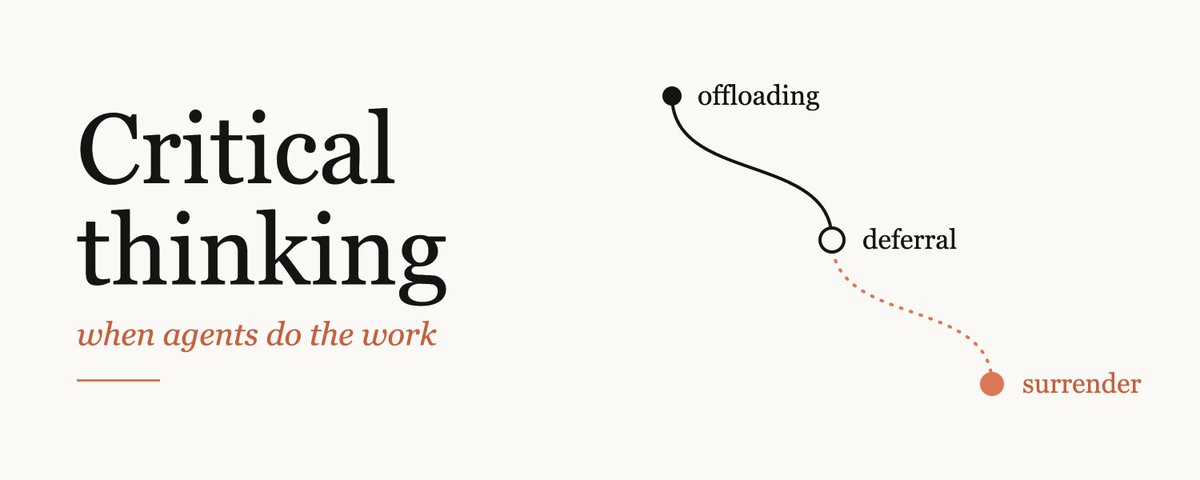
agent 时代,批判性思维不会自己发生了,你得刻意把它排进每天的工作里。
@addyosmani 在 Anthropic 做 Claude Code,之前在 Google 带过 Chrome 和 Gemini 的开发者体验。天天造 agent 工具的他提醒大家:别把判断也交出去。
批判性思维,为什么变难了?
以前,思考就发生在「提问」和「拿到答案」之间。现在这段时间只剩几秒。
模型越强,明显的错越少,答案写得漂亮又大体正确,你就懒得再看第二眼。同时跑再多 agent,盯结果的还是你这一双眼睛。
三种状态,越往下越危险
- 交出去:活让 AI 干,结果你自己负责。这是正常用法
- 直接用:AI 的答案直接成了下一步的起点,不再当成要验证的猜想
- 不再查:AI 的结论悄悄变成你的结论。沃顿的 Steven Shaw 和 Gideon Nave 叫它「认知投降」
往下滑是一点点发生的:上一条认真读,下一条扫一眼,再下一条只看框架,直到有人问起其中一行,连让 agent 帮忙你都讲不清。
动手前,先问自己:
- 我有自己的猜想吗?猜错也行
- 要怎样它才算错?然后真去查
- 是让它帮我想,还是替我想?
agent 说做完了,这样验收:
- 开工前就定好「怎样算验证过」,事后再定,你会给任何结果找理由
- 先看它跑了哪条命令、输出了什么,再看总结
- 测试变绿,问一句:它证明了什么,没证明什么
- 开一个新上下文的子 agent 再审一遍;最后问「我漏了什么吗?」
- 总结类的活,抽两份原文,核对你结论依赖的那个数字
产出多到审不过来,别再开新会话,要么收紧检查,要么慢下来。推理要留在自己手里。
我的建议:
- 跑不简单的任务前,先写一句我预期会得到什么
- agent 做完后,写下一件它没检查到的事
- 让 agent 列出它替我做的决定和假设,再挑几行考自己
- 每周一次,不用 agent,亲手做一件忘了会很麻烦的事


Cloris 🌱 retweeted
我的 Gemini 给我的未来十年建议!大家可以试试问 Argon 这个问题:“Your advice for next 10 years. No explanations.” 看能否得到类似的回答?这个建议可以说相当通透了👀
1. 掌控核心瓶颈:能源、算力与稀缺物理资产。
2. 构建“人机双向共生”,而非与算法内卷。
3. 锤炼主体性(Agency)与审美品味,而非单纯的执行力。
4. 守护底层生理硬件:睡眠、体能与深度专注力。
5. 将“注意力主权”视为你最高杠杆的资产。
6. 设计在你离线时依然能产生复利的系统。
7. 深耕高信任度的线下真实人际网络。
8. 保持认知的流动性,让“反学习”与迭代的速度快于模型更新。
9. 精通提出正确问题的艺术。
10. 重仓那些永远无法被数字化的体验与情感连接。


agent 账单贵不贵,先看缓存命中,不看单价。
agent 的钱大多花在「重读」:没有缓存,同一个任务要贵 3.6 倍
@arena 拿 Agent Arena 9/12–10/23 的 26,225 个会话(30 个 agent、13 家实验室),加上 6 家实验室 2024 年 1 月以来的缓存价格,算了 prompt cache(提示缓存)到底省了多少。
为什么缓存这么要紧
- agent 每一轮都要把之前的对话、文件、工具结果再读一遍
- 86–96% 的 token 是它读过的上下文,自己写的大约每 100 个里只有 1 个
- 两年里缓存折扣从 0 到 95%:2024 年初读缓存和新输入一个价,现在前沿模型只收输入价的 5%,DeepSeek 从春天起是 2%
- 把缓存 token 全按输入价重算,前十 agent 的典型任务要贵 3.6 倍(+260%)
- 缓存每失效一次,典型任务多花约 5%;Claude Fable 5.1 每 10 个会话里有 1 个多出 18% 以上
我的建议:
- agent 日志里加一列缓存命中率,每周看一次
- 系统提示词、工具列表放在最前面,少改动;长任务中途别停太久,免得缓存过期


3
8
656
AI-for-Science Weekly | 10.25–10.31 🌱
【Cloris’s Signal】
本周 AI4Science 跨入三个更难的环节:人体试验、连续湿实验和真实器件验证。模型让候选更便宜,价值开始向能制造、测量和验证结果的 physical loop 转移。
🩺 ① Insilico ISM6331|L5 / L4
AI 辅助设计的抗癌小分子首次报告人体信号:间皮瘤患者中 4/22 出现客观缓解,最高剂量组为 2/5,其中一名缓解约持续一年。
这是早期 Phase 1,无对照且样本很小。它验证了分子具有临床活性,AI 是否提高研发成功率仍要看随机 Phase 2a。
🔬 ② BigHat × Anthropic|L3 / L4 / L2
团队在 10 周内完成七轮实验,测试 1,232 个抗体。每轮结果都会决定下一批设计,最佳候选的结合力提高约 9 倍,热稳定性提高最多 18°C。
这已经接近真实闭环:
Design → Make → Measure → Learn
BigHat 控制自动化实验、样本追踪和原始仪器数据,这些资产比单个模型更难替换。完整成本、人工介入和数据复用权仍未公开。
☀️ ③ AI-1 钙钛矿材料|L5 / L4 / L3
研究从 9 万多个结构中筛出可合成界面材料。真实太阳能器件达到 27.2% 效率,在 65°C 连续运行 2,000 小时后仍保留超过 95% 初始效率。下一关是大面积组件、批次良率和量产成本。
📈 Public-market watch
- CRL|L3/L2: Virtual Control Group 将进入 Ipsen 的前瞻 GLP 毒理研究。看监管接受、结果一致性和客户复购。
- ILMN|L3/L2: Q3 收入增长 4.2%,NovaSeq X 装机和临床需求较强。看耗材复购与 BioInsight 付费采用。
- TWST / AZTA|L3: 正在扩充抗体测试、DNA synthesis 和基因文库能力。看订单、交付周期、QC 与毛利。
- TEM / RXRX / SDGR / TXG: 下周关注临床分母、数据业务收入、software retention 与仪器耗材拉动。
(Layers:L1 算力|L2 科学数据|L3 实验设施与自动化|L4 模型与 Agents|L5 应用、药物与 IP)
🤖 Made with AI

1
323