

Banny|嗯哌AI 主理人 · AI 工作流搭建者 NotebookLM 教程全网 50 万播放|开源 Dify 工作流 GitHub 2.7k⭐ 白天搭能直接抄的 AI 工作流,晚上吐槽被 AI 坑的日常
Joined August 2023
- Tweets1.6K
- Following825
- Followers1.2K
- Likes1.8K




Pinned Tweet
给各位 𝕏 友人的一个小说明:
如果有朋友发现我没回关,先说声抱歉,真不是高冷,可能单纯是你的主页内容有点“吓”到我了 😅
点开主页,如果满屏都是擦边图、高频键政,或者纯粹的情绪输出与碎碎念(无任何贬义,纯粹指和我频道不同)——在 𝕏 上表达这些完全是你的自由和喜好,我百分之百尊重,只是确实不太适合我的信息流。
每个人刷𝕏“图的东西”不一样,我想把自己的时间线留给更聚焦技术、工具和思考的内容。
道不同不相为谋,但依然祝大家玩得开心。没回关的地方,见谅!🙏
3
4
516
一条帖子跑了 20 万浏览,可我却一点也不开心!
原本我以为,能来 X 的人,至少具备两样东西:折腾精神,和容得下不同声音的格局。
结果现实是,很多人连正文都没看完,上来就是一顿脏话输出。
翻完所有评论,我发现一个很有意思的规律:
认真反驳的人,都会先引用我的原话,再说哪里不同意。比如有人说:“让普通人去折腾 API,是技术人员的傲慢。”——这话我服,也补全了我没写到的那一块。
骂人的人,基本只看了标题那一句,就开始颅内高潮。
后来我想通了:20 万浏览,意味着算法把我推给了大量根本不认识我的人。
流量破圈的代价,就是要接受陌生人的误读。
为了不被垃圾情绪消耗,我给自己立了三条铁律:
1. 满嘴脏话的,不回,直接屏蔽;
2. 言之有物的反驳,认真回复;
3. 同一个逻辑,说清楚一次就够了,绝不纠缠。
有不同看法完全可以和平探讨。靠骂人赢不了任何讨论,只会让懂的人离开。
1
1
97
顺手做了一个小样本统计(近百条评论),数据挺说明问题的:
•整体评论区里,张口就骂的比例占了 15%~20%;
•评论者中,蓝 V 认证账号占比约 25%~27%;
•而在所有蓝 V 评论里,明确爆粗口或人身攻击的只有 1 个(占比仅 1% 左右)。
数据不会说谎:真正花钱认证、在平台认真经营自己羽毛的人,几乎不会下场当喷子。 那些满嘴脏话的,绝大多数都是零成本的“三无小号”。

昨天 DeepSeek 网页端限制长对话(7天不活跃断聊+单次4万字+日额度上限),国内评论区集体破防,甚至跪求官方开付费;结果刷了一圈 X 简中圈,画风却是一片祥和,纷纷指责国内网友“白嫖久了真当成自己的了”。
同样一件事,为什么两个圈子的体感割裂这么大?说白了根本不是觉悟高低,而是“选择权”完全不对等 👇
1️⃣ 国内绝大多数普通人,没有渠道也没有条件去折腾海外卡和复杂网络。无门槛、全免费的 DeepSeek 网页端,几乎是他们唯一能摸到的顶级生产力(甚至很多人靠它写长篇故事、存了几个月的设定和陪伴,一刀切掉确实像“失恋”)。
2️⃣ 而混迹 X 的人,手里普遍握着 Claude、GPT、Gemini 的订阅或者直接跑付费 API。DeepSeek 网页端限不限流,根本动摇不了他们半点核心业务。
自己手里端着满汉全席的人,回过头去嘲笑只有一碗免费面条的人“吃相难看”,这不叫理性客观,这叫现代版“何不食肉糜”。
理解别人没有退路时的慌张,比站在制高点上指点江山体面得多。
你觉得这波国内用户破防,是因为白嫖惯了,还是因为真的没得选?评论区聊聊 👇
2
1
169
357 次运行里,85 次 agent 正常退出了,什么都没留下。
这是北京科技大学的 Hao Wang 和 Honor 的 Ting Huang 做的对照实验:5 个本地 agent 框架、4 个 5B 以下的小模型、18 个要出产物的任务。357 次有效运行里,85 次正常退出,却没有留下任何一件声明要交的产物;127 次干脆一件产物都没留下。
更扎心的是,就算检查器打了满分也不能信:抽查 34 次满分运行,8 次两个评审都认为内容是错的。拿掉 Mingbird 的防重复规则,0.75B 的模型上 18 个任务里 8 个交不出东西。
完成有三层,缺一层都不能算干完了——进程结束了、产物存在了、产物对了;只看退出码,等于只验了第一层。
我的做法是这样:
第一,agent 的验收只看产物不看退出码——任务说要交什么,就去那个位置找那个文件,找不到就是没干完,不管它说得多漂亮。
第二,产物还要验内容:文件在不等于写对了,跑一遍测试、打开看一眼关键段落,满分也得抽查。
第三,防重复是框架的事,不是模型的事——小模型最容易在同一个地方打转,框架里要有"别重复"的规则,交之前重读一遍任务、确认产物齐了再放行。
第四,分开记三层数字:跑了多少次、交了多少产物、产物里多少是对的,失败先定位在哪一层,再决定是换模型还是修框架。
一句话:退出来不等于交出来了,交出来不等于交对了。
你的 agent 有没有过"说干完了,一看什么都没有"的时候?
arxiv.org/abs/2611.21407

3
4
319
风格指南写得越像你,AI 写得越不像你。
这是 Every 评估负责人 Mike Taylor 折腾了 6 年得出的结论。早在 2023 年,他用 AI 写的文章就已经能骗过朋友和同事,没人分得出真假。但他自己一眼就能看穿——甚至同事问起他“写过”的某段内容时,他根本认不出那是自己的想法。
问题就出在风格指南上:指南里列的全是他的“招牌动作”,比如自嘲、单句成段、“Here's the thing”这类口头禅。AI 照单全收、用力过猛,最后写出来的不是他,而是一幅对他的夸张漫画。
后来他换了个思路,把“描述风格”变成了“考试优化”:
1.攒题库并划出考卷:收集 185 篇自己的文章(共 33.5 万字),特意留出 54 篇当“期末考卷”,绝不提前喂给 AI。
2.提取纯干货简报:把每篇文章拆解成“只留实质、不留风格”的简报——论点、大纲、事实、来源、故事、原话全保留,但把句式、开头钩子、笑话全拿掉。
3.设立盲测判卷人:拿真实的原文章当标准答案,让 AI 对比两份新写的草稿,挑出更像他的一份(为防偏差,还会调换草稿顺序各比一次)。
4.用优化器迭代提示词:让 AI 不断修改写作指令(Skill),生成草稿去判分,只保留得分更高的改法。
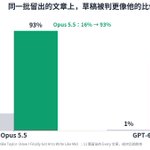
结果非常惊人:在那 54 篇没见过的“考卷”上,Claude Opus 5.5 写出的草稿被判定“更像他”的比例,直接从 16% 飙升到了 93%。他自己从有想法到成稿,也从以前的一整天缩短到了 1 小时,手动改稿更是从几百处降到了 44 处。
核心逻辑只有一条:风格不是靠总结描述出来的,而是靠考试“考”出来的。 而且考卷必须是留出来的真文章,否则 AI 只是在死记硬背你的旧作。
如果你想复刻这套做法,可以按这四步走:
• 备素材:攒 12 到 25 篇同一平台的文章(如果文风变了,就用最近的 30 篇);没有文章,就用最近 30 场会议的录音转文字,千万别用推文和邮件凑数。
• 做简报:只提炼论点、事实、来源、故事和原话,剔除所有修辞和句式。关键原则:简报里必须有你的核心观点,且你喂给 AI 的字数要比它吐出来的多,否则写出来的就不是你的思想。
• 建判卷:用原文章作对照,让 AI 盲测两份草稿(正反顺序各测一次),并要求它写出两份草稿的具体差距。
• 搞迭代:只保留让得分变高的指令修改;同时把你每次人工改稿的痕迹喂回去,作为下一轮的训练数据。
一句话总结:先想好怎么考,再想怎么改。
你平时让 AI 写过东西吗?写出来的有“内味儿”吗?


4
2
380

今天看 Cline 核心开发者 Ara Khan 的分享,感触很深:当 Agent 连自己的 Harness(测试与执行框架)都能通过 17 小时递归自改进(RSI)完成性能跃升,当大模型能自己优化内核把推理成本砍掉 20% 时,那种“写点业务逻辑就能安稳过日子”的安全感正在快速失效。
很多开发者天天忙着卷各种套壳应用,本质上是在用战术上的勤奋,掩盖战略上的偷懒。那些一周就被模型版本迭代清零的项目,不过是在沙滩上盖房子。
要逃离被 AI 边缘化的命运,核心逻辑只有一条:尽量往 RSI(递归自改进)的闭环靠拢。
去死磕那些大模型现阶段搞不定、或者能从底层算力、长周期反馈、硬件交互、自动化基准测试里分一杯羹的真实复杂问题。
别做大模型的复读机,去做构建系统和推动边界的那个人。
youtube.com/watch?v=iK9gmxXy…

6
4
353
Instacart (你可以把它理解成“生鲜杂货版的 Uber”或“超市代买外卖软件”)把搜索改写的覆盖率从 50% 做到 95% 以上,搜不到东西的投诉少了一半。办法不是换个更大的模型,而是把"读懂人话"拆成三层。
用户在搜索框里写"无麸质面包"、"1% 牛奶"、"2% 减脂超巴氏巧克力奶",系统得猜出他到底想买什么。Instacart 以前的办法是各管各的模型:一个管分类、一个管改写、一个管拼写纠错,各有各的数据和部署。数据还脏:用户搜面包最后买了香蕉,不代表面包是水果;人工标又贵又慢;越是冷门长尾的怪话,越没历史可学;"健康食品"这种宽泛词,又不知道该归到哪一类。
新办法是一个大模型当底座,分三层。
第一层,给模型喂业务上下文(商品目录加上历史购买规律)再问;
第二层,模型答完先过一道护栏,拿去跟商品目录对,跑偏的直接扔掉;
第三层,把大模型教出来的本事,教给一个 80 亿参数的小模型,专门跑实时搜索。
分类也是三步走:历史数据先提候选,大模型再排个序,护栏最后把关。
改写分三种,各写各的提示词:同义词、放宽一点、换个替代品,三种的准确率都在 90% 以上。
速度是这么压下来的:先算好的缓存起来,只有 2% 的搜索要实时算;小模型的适配器合并进底座,再换上更快的显卡,700 毫秒压到 300 毫秒。结果是尾巴上的冷门搜索,用户平均少翻 6% 的页面,搜不到东西的投诉少了一半。
搜索好不好用,不看模型多大,看"读懂人话"有没有拆成能检查的步骤——数据提候选、模型做判断、护栏兜底;少了护栏这一层,模型猜得再准也可能跑出商品目录。
我的做法是这样:
第一,先把"读懂"拆开写下来——你的系统里,谁负责提候选、谁负责判断、谁负责兜底,三层缺一层就是赌。
第二,冷门问题别靠历史:没有历史的长尾查询,用大模型先离线算好答案存进缓存,实时只留给真正没见过的问题。
第三,大模型当老师、小模型当学生:老师离线慢慢教,学生在线快快答;学生答错了先看老师给的例子对不对,别急着怪学生。
第四,速度不够别先换更大的模型:先看缓存能不能顶住 98% 的量,再看适配器能不能合并,700 毫秒压到 300 毫秒靠的是工程,不是参数。
一句话:搜得准不是因为模型大,是因为每一步都有人把关。
你搜东西的时候,有没有遇到过系统完全没懂你在说什么?
6
6
468

Gemini Notebook 又一新功能:
一句 “帮我创建一个网站”,就能基于你的来源资料出一个网站。仪表盘、项目跟踪都能做。


You can now turn your sources into interactive, shareable websites 🤯
Just type "make me a site" in the Chat with a description of what you want to build (interactive dashboards, project trackers, etc). Once built, open it in a new tab or share it directly with others.
Available globally on web for ALL (18+) users. Share your examples below!
1
3
515
昨天 DeepSeek 网页端限制长对话(7天不活跃断聊+单次4万字+日额度上限),国内评论区集体破防,甚至跪求官方开付费;结果刷了一圈 X 简中圈,画风却是一片祥和,纷纷指责国内网友“白嫖久了真当成自己的了”。
同样一件事,为什么两个圈子的体感割裂这么大?说白了根本不是觉悟高低,而是“选择权”完全不对等 👇
1️⃣ 国内绝大多数普通人,没有渠道也没有条件去折腾海外卡和复杂网络。无门槛、全免费的 DeepSeek 网页端,几乎是他们唯一能摸到的顶级生产力(甚至很多人靠它写长篇故事、存了几个月的设定和陪伴,一刀切掉确实像“失恋”)。
2️⃣ 而混迹 X 的人,手里普遍握着 Claude、GPT、Gemini 的订阅或者直接跑付费 API。DeepSeek 网页端限不限流,根本动摇不了他们半点核心业务。
自己手里端着满汉全席的人,回过头去嘲笑只有一碗免费面条的人“吃相难看”,这不叫理性客观,这叫现代版“何不食肉糜”。
理解别人没有退路时的慌张,比站在制高点上指点江山体面得多。
你觉得这波国内用户破防,是因为白嫖惯了,还是因为真的没得选?评论区聊聊 👇
很多人还在用“本来就是免费的,限制一下很正常”来替 DeepSeek 辩护,其实完全搞反了商业逻辑。
商业公司的“免费”,从来不是因为做慈善、发大爱,而是一种极其标准的市场策略:用免费换取真实的用户测试数据、唤醒口碑、抢占流量入口、扩大品牌知名度。
用户付出了时间、信任和真实的交互数据,这是一场双向交换,不是单方面的施舍。
既然产品正式面向大众上线,就该做好算力预案;退一万步讲,哪怕突发算力不够用,起码提前发个正式公告,给正在深度使用的老用户一个交代、一个备份和迁移的缓冲期——而不是不声不响地直接一刀切。
说句心里话:国内 AI 公司里,我最喜欢的就是 DeepSeek,没有之一。正因为真的喜欢,所以这件事——理智上我完全理解,但情感上真的很难接受。
很多人还在用“本来就是免费的,限制一下很正常”来替 DeepSeek 辩护,其实完全搞反了商业逻辑。
商业公司的“免费”,从来不是因为做慈善、发大爱,而是一种极其标准的市场策略:用免费换取真实的用户测试数据、唤醒口碑、抢占流量入口、扩大品牌知名度。
用户付出了时间、信任和真实的交互数据,这是一场双向交换,不是单方面的施舍。
既然产品正式面向大众上线,就该做好算力预案;退一万步讲,哪怕突发算力不够用,起码提前发个正式公告,给正在深度使用的老用户一个交代、一个备份和迁移的缓冲期——而不是不声不响地直接一刀切。
说句心里话:国内 AI 公司里,我最喜欢的就是 DeepSeek,没有之一。正因为真的喜欢,所以这件事——理智上我完全理解,但情感上真的很难接受。
昨天 DeepSeek 网页端限制长对话(7天不活跃断聊+单次4万字+日额度上限),国内评论区集体破防,甚至跪求官方开付费;结果刷了一圈 X 简中圈,画风却是一片祥和,纷纷指责国内网友“白嫖久了真当成自己的了”。
同样一件事,为什么两个圈子的体感割裂这么大?说白了根本不是觉悟高低,而是“选择权”完全不对等 👇
1️⃣ 国内绝大多数普通人,没有渠道也没有条件去折腾海外卡和复杂网络。无门槛、全免费的 DeepSeek 网页端,几乎是他们唯一能摸到的顶级生产力(甚至很多人靠它写长篇故事、存了几个月的设定和陪伴,一刀切掉确实像“失恋”)。
2️⃣ 而混迹 X 的人,手里普遍握着 Claude、GPT、Gemini 的订阅或者直接跑付费 API。DeepSeek 网页端限不限流,根本动摇不了他们半点核心业务。
自己手里端着满汉全席的人,回过头去嘲笑只有一碗免费面条的人“吃相难看”,这不叫理性客观,这叫现代版“何不食肉糜”。
理解别人没有退路时的慌张,比站在制高点上指点江山体面得多。
你觉得这波国内用户破防,是因为白嫖惯了,还是因为真的没得选?评论区聊聊 👇
Google 上个月底上了 Antigravity 插件市场。
翻完文档我发现:它跟 DeepSeek Harness “一切皆插件”的理念有着本质的不同。
Antigravity 的插件是个配置包。
一个 plugin.json,最多装五样:Skills、MCP、Rules、Hooks、子代理。
市场里点一下就装,要 token 的弹个表单填好。
这五样都是挂在 Agent 身上的,Agent 本身是固定的。
DeepSeek Harness 是反过来的。
它自己就是插件拼起来的,连 Agent 循环、子智能体都在官方插件列表里。
插件能扩展的是工具、技能,还有界面。
而且不用手写,创造模式里说一句”帮我写个番茄时钟插件”,它自己写完、装好。
一个是给 Agent 装配件,
一个是整台机器都能拆。
你更想要哪种?
A 市场一键装,够用就行
B 底层都能换,自己说了算
评论区回个字母 👇

Announcing new plugins marketplace in Antigravity! We've made it easier to search and discover customizations.
2
3
420
我只打了一句话,DeepSeek Harness 就直接接管我的电脑,全自动完成从读资料 → 出图 → 进 PS 的全套设计! 🚀
这句话是:「打开我的 photoshop,然后设计一张插件推广海报」。
DeepSeek Harness 调用 Computer Use 功能干了三件事,我一次鼠标没点:
1.读我那个插件目录的 README,自己挑出能上图的文案和数字
2.写 HTML,用无头 Chrome 渲出 1600×2000 和 3200×4000 两张
3.open -a "Adobe Photoshop 2026" 启动它,把图丢进画布,再截图回来给我核
最后 PS 里躺着一张 3200×4000、RGB/8 的图,缩放 33.3%。
不过,图是扁平单层,改一个字都改不了。它干的是「送到 PS 里给你看」,不是「在 PS 里排版」。要分层 PSD,得再让它写脚本 —— 这一步我没做。
我赌一句:Computer Use 会先淘汰「导出下载再手动导入」这一整段流程。
你觉得下一个被它干掉的跨软件繁琐操作是什么?👇
#DeepSeek #ComputerUse #AI工作流 #Photoshop


