






GPT-6.2 这么强吗?
Paweł Huryn 用自己的 Bug Hunt Bench 测了 GPT-6.2 Astra,不是官方成绩。两个真实仓库共 105 个植入 bug,模型在各自的 agentic CLI 里每仓一轮,只计盲评验证修好的植入问题
Codex CLI、max、3 次平均:62.7/105,列表价估算 $28.35,耗时 121.8 分钟,为当前榜首。
同模型 xhigh、3 次平均:60/105,$23.53
同榜 GPT-6 Astra max(也是 3 次平均)为 45/105。作者写明这次换了更新的 Codex 和 Linux 云机器,和旧行的差距是模型加客户端加机器,不能只看成模型提升
bughunt.productcompass.pm/


I tested GPT-6.2 Astra on real work. 2 repos, 105 replanted bugs. Find and fix what you can.
It's the new #1. The results:
- GPT-6.2 Astra (max): 62.7 for $28.35
- GPT-6.2 Astra (xhigh): 60 for $23.53
- Fable 5.2 (max): 58 for $139.65
- Gemini 4 Carbon (high): 57.3 for $31.32
- Sonnet 5.5 (max): 51.3 for $154.03
- GPT-6 Astra (max): 45 for $33.03
From GPT-6 Astra to GPT-6.2 Astra: +17.7 points at max, +17 at xhigh.
Whatever people say about other use cases, it's a code review beast.
GPT-6.2 Sol and more effort levels drop soon in the thread 🧵

Qwen3.8-27B 被 kaiPTQ 量化到 6.73 GB!!!
作者称可放进 12 GB RTX 3060
这个 chimachima 检查点不是普通 GGUF:需 kaiLLM 0.1.0rc5,llama.cpp 加载不了,目前仍是付费早期访问
作者在 RTX Pro 6000 上自测 GPQA Diamond:同体积下,chimachima 为 68.75%,Unsloth UD-IQ1_M 为 46.25%;9.60 GB 的 UD-Q2_K_XL 为 85.0%
仅测 20 题×4 次,使用 medium reasoning。作者提醒,小于约 10 分的差异意义不大,尚待第三方复核
huggingface.co/kaitchup/Qwen…

5
6
441
8×H200 跑 DeepSeek-V4.1-Flash,SGLang 优化后端到端延迟最多降 63.9%,但逐 token 延迟增加
Ant International AI Infra 采用预填充、解码分离,各用 4 张卡;标称输入 65,536 token、输出 512 token,每组测 3 次,每次 512 请求
合并配置启用 bounded replay,预填充分块从 8,192 增至 16,384,并包含多项运行时改动,不能归功于单项优化
8 组测试:首 token 延迟降 41.0%–79.0%,逐 token 延迟增 2.6%–51.9%
GSM8K 单次测试 1,319 题,准确率从 96.74% 降至 95.38%,原因尚未确认
lmsys.org/blog/2026-11-05-de…


Optimizing DeepSeek-V4.1 on H200 with SGLang PD Disaggregation
The AI Infra team at @Ant_Intl served DeepSeek-V4.1-Flash from @deepseek_ai on 8×H200 with PD disaggregation.
This blog walks through how they tackled it: a cheaper sparse-attention Indexer, bigger Prefill chunks, leaner MoE communication, and late layers that compute only the last 128 tokens.
Highlights:
· E2E 15%–64% lower, TTFT 41%–79% lower vs the original baseline, across 8 cases (64K in / 512 out, 50/70/90% prefix hit, concurrency 4–32)
· The 128-token mode cuts TTFT by up to a further 46.7%
· The cost: TPOT 3%–52% higher, GSM8K 96.74% → 95.38%
Read the full blog below

3
3
161

Gemini 4 Hydrogen(gemini-4-hydrogen)有 4 档 thinking_level:low、medium、high 和新增的 xhigh,默认是 high
官方文档把 high 定为大多数任务的推荐默认值,包括复杂编程、agentic 执行、工具调用和多模态知识工作
xhigh 留给 high 不够用的困难多步编程和 agentic 问题,会增加延迟和 token 用量,简单提示词上可能 overthink
要降延迟可改用 medium 或 low;官方建议 4 档都跑评估,并把 max_output_tokens 设高以免截断,再选能达到质量要求的最低 thinking_level
aistudio.google.com/docs/wha…


Gemini 4 Hydrogen thinking level guidance:
- high (default): Recommended for most tasks
- xhigh (NEW): Save for your hardest problems; on simple prompts, it might overthink.
- medium & low: drop down for lower latency when your evals still pass

3
2
130
Ming-3.0-audio-flash 在 Artificial Analysis Speech Reasoning(Big Bench Audio)得分 99.8%,在已评估 42 款模型中排第 1
第 2、第 3 为 StepAudio 3 Realtime 99.7%、Qwen Audio 3.0 Realtime Plus 99.2%
Grok Voice 3.0 为 98.5%,Gemini 3.8 Live Extended Thinking (High) 为 97.7%,GPT-Realtime-2.1 High 为 95.8%
测试共 1000 道音频题,改编自 Big Bench Hard;模型收音频、输出音频,按对错计分
artificialanalysis.ai/speech…


Ming-3.0-audio-flash ranks #1 globally on Artificial Analysis Speech Reasoning (Big Bench Audio) with 99.8% accuracy.
Ahead of Grok Voice 3.0, Gemini 3.8 Live Extended Thinking (High), and GPT-Realtime-2.1 High.

2
148

Gemini 4 Hydrogen 把成千上万个单元格缩小,把 Google Sheets 做成像素动画画布
官方帖写到,这是在 Google Antigravity 里完成的,做成了动画场景
官方博文写到,结合 Python、原生 =LET(...) 公式和条件格式,直接在实时表格里绘制并播放完整动作
官方视频里能看到 3 个表格:Seaside Train Station、Cyclist & Drifting Clouds、Autumn Canopy
付费的 Google AI Pro 和 Ultra 订阅者可在 Google Antigravity 里使用 Hydrogen,企业也可在其中部署
blog.google/innovation-and-a…


Gemini 4 Hydrogen turned Google Sheets into a pixel-art canvas.
Using @Antigravity, the model shrank thousands of cells to create animated scenes.
1
293

Hy4 flash 开源权重已上线,官方称 Decode 可超 150 tokens/s
一起放出了 3 个版本:
Hy4 flash:指令微调版
Hy4 flash-FP8:FP8 量化版
Hy4 flash-base:预训练基座,不是对话模型
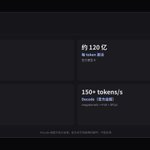
官方模型卡:总参约 2200 亿(含约 640 亿 Engram),每 token 激活约 120 亿,原生图文,上下文 100 万 token
官方自报:结合 megakernels、4 bit 量化和 DFly2,Decode 可超过 150 tokens/s,但没写测速用的硬件
huggingface.co/tencent/Hy4-f…

36
Hy4 flash 开源权重已上线!!官方称 Decode 可超 150 tokens/s
权重已经放到 Hugging Face、ModelScope 和 GitCode,一起放出的还有 FP8 量化版和预训练 base。官方模型卡写,总参约 2200 亿(含约 640 亿 Engram),每 token 激活约 120 亿,原生图文,上下文 100 万 token。
【三个版本怎么用】
Hy4 flash 是指令微调版,FP8 是量化版,base 是预训练基座,不是对话模型。官方自报,结合 megakernels、4 bit 量化和 DFly2,Decode 可超过 150 tokens/s,但没写测速用的硬件。
huggingface.co/tencent/Hy4-f…

6
6
219
