后端技术专家 | Learn to build with AI | 热爱开源精神 | 分享最前沿AI资讯,以及我的深度思考和实践
Joined May 2011
- Tweets1.5K
- Following215
- Followers3.1K
- Likes1.9K





《pstack 完全指南 pt.2》重点总结
这篇解决两个问题:
1. 如何与智能体对齐需求
2. 如何进行有效的规划和设计
如何与智能体对齐需求
lauren 会组合使用以下四个技能:
1. /how: 系统现在怎样运行?
2. /why: 为什么这样设计,有什么历史约束?
3. /recall: 过去的对话提供了什么背景上下文?
4. /teach: 能否讲清机制与原因,让人检查理解?
举例:
> /recall 我过去 7 天修复虚拟化 bug 和性能问题的工作。使用 /how 和 /why 了解我们当前的虚拟化实现是如何工作的
* 注意,/recall 能自动搜索你的 harness 的会话历史记录,但这并不是唯一方式。它的目的是为智能体扩充你的环境上下文,以便智能体能有更加全面的视角。所以我认为在这个阶段应该尽可能多的给智能体主动提供环境上下文,比如日志、数据库、外部依赖、外部文档等
这样沟通的好处不仅限于让人类更能全面的理解当前现状和问题,更重要的是推动智能体掌握更全面的上下文,避免它们基于少量的信息匆忙得出片面的结论
* 另外推荐一个我觉得很好的 skill: github.com/QingYunA/answer-m… ,当智能体长篇大论或不说人话时,我就会用这个 skill 帮我生成一个网页来理解
如何进行有效的规划和设计
第一,lauren 推荐一种 “逆向工作法” 叫 README 驱动开发 。具体来讲她会用 /technical-writing 技能,在规划阶段写出不同层次的用户教程,打磨好后的教程将成为智能体的行动目标
把写用户文档作为打磨设计文档的手段,好处是可以站在 high-level 的视角逐层打磨设计文档,而不是事无巨细的 grill-me
第二,她建议 “用代码来做规划”,她会使用 /poteto-mode 原型设计工作流 来进行快速原型开发,使用 /architect 技能扇出(Fan-out)多个并行智能体产出不同候选设计方案,最后综合成一份最优设计方案并进入实现
多个并行智能体扇出的方式,有点像赛马机制。核心思想是利用不同家族的模型进行并行研究,以避免单一模型的局限性。然后从所有返回的内容中综合整合出最优方案(不是只选一个模型的结果)。这种机制在 pstack 的整体设计中会有多处体现
这里需要注意,并行赛马比较的并不是最终实现,而是草图、类型定义、接口定义组成的一套接口规范层面的设计草案
lauren 特别提到,她“从不费神去对抽象计划做对抗性评审”的原因就来自于此。如果用类似 grill-me 这类 skill,难免会陷入纸上谈兵的境地,既费人又容易过度设计。而让代码自己去竞争评审能更落地且节约人脑细胞
补充说明一点:/architect 在 D 阶段人类确认后,会自动进入实际代码的实现阶段。这里如果你是比较大的任务,可以在人类确认后掐断(pstack 有提供其他的长周期任务工作流),举例如下:
> /skill:poteto-mode 为 <功能> 制订实现计划。先用 architect with checkpoint 完成设计并暂停。本轮不要进入 Phase D,也不要实现功能逻辑。将设计方案转化为一份计划
---
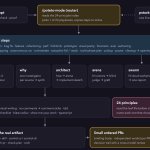
以上是我在看了这篇文章以及相应 skill 源码后的一份总结,有趣的是我在总结过程中就已经会应用上以上提到的技能了。包括下面这张图的文稿也来自于 /teach 和 /technical-writing。所以大家如果有不懂的地方,非常推荐直接跟 pstack 对话,另外更推荐直接看它的 skill 实现,很多宝贵的设计思想
/architect skill 流程图

ALT pstack architect skill

《pstack完全指南 pt.1》总结
核心的验证能力
/create-verification-skill 本质上提供三种能力:
1. 验证技能入口
驱动你的应用执行真实的验证流程,例如通过浏览器工具执行真实的应用截图、点击、发送消息等动作。通过这些动作做自动化端到端验证,定义验证标准并拿到证据
2. CLI 工具
为了能高效验证,/create-verification-skill 会配套的生成一套针对你应用的 CLI 工具,以便验证技能能够通过这些工具高效且低成本的执行验证
3. 功能地图
/create-verification-skill 还会生成一套针对你当前应用的功能地图文档,这套文档成为验证执行时的“锚点”,比如全面回归验证会遍历功能地图的所有功能点进行验证
当你调用 /create-verification-skill 时,它会将以上三种能力结合在一起,生成一个 skill 包放在你的当前项目目录下,以便你随时调用验证
大家如果对以上的概念感觉比较模糊的话,lauren 还特别写了一个 example 项目,可以让你看到验证技能跑完得到的这套 skill 包具体长什么样子:
github.com/poteto/verificati…
配套的 /maintain-verification-skill 技能用来更新验证技能生成的 skill 包。最佳实践是起一个定时任务定时跑这个 skill,以保障你的验证技能包是随项目迭代不断更新的状态
对于文中提到的 “用云端智能体代替 worktree” 的方法,我倒是觉得不一定需要。云端智能体需要更多成本以及更加完整的环境上下文,对于大多数小型项目来说一套本地开发测试环境 + 一套预发布验证环境我觉得就足够了
---
另外,如果你当前使用的 harness 不是 Cursor,想使用 pstack 的话,以下这个开源项目就是为你准备的(我横向比较了多个项目,这个是我觉得支持面最广且社区更新最频繁的一个):
github.com/michael-denyer/ps…
它支持 Claude Code、Codex、Copilot、Pi、OpenCode 等 harness 使用 pstack,且会紧密同步 pstack 官方的发布。利用它你可以在无需 Grok 订阅的情况下使用 pstack


分享下我在多 Agent 管理时的一点经验:
1. 不要把任务切分的太细,重点放在设计和验收
正如宝玉老师所说,管多 Agent 正如管人一样。新的技术管理者最容易陷入的误区就是事无巨细的管,导致自己最容易成为瓶颈
管 Agent 也是,如果每个 Agent 的执行粒度是几分钟的话,很快人的脑袋就晕了,上下文切不过来,也容易管出问题
我目前体会是每个任务控制在小时粒度(长的话有几小时的)是最舒服的,这就需要设计阶段多花些时间和 Agent 调研和讨论,形成文档化的共识后让它去慢慢跑。与此同时我再切到下一个 Agent 讨论和布置任务
2. 验收要落在实处,“多少测试用例绿了” 不能说明任何问题
Agent 在跑长程任务后很容易跑出几十上百个单元测试,这些不是质量证据,甚至不能说明 spec 的遵从度。只有从设计角度出发,写一套符合需求的端到端验证,拿到验证证据才算数
这方面特别推荐使用 pstack 的以下两个元技能(用来创建skill的skill):
/create-verification-skill
/create-formal-verification-skill
第一个能帮你创建一个 e2e 测试的基础设施、以及当前项目的功能地图,根据功能地图进行真实的e2e测试:
nitter.gq/i/grok/share/80ddfc71c…
第二个是对第一个测不到的地方的补充,比如无法枚举的测试、并发竞态条件等,用形式化验证来做数学证明,确保复杂状态的正确性
相对应的 lauren 还提供了两个维护更新这两个skill的元skill,简单说就是项目功能在不断迭代过程中,验证类的skill也要随项目不断更新才行
3. 与多 Agent 的沟通方式:不要打乱自己的节奏
刚开始管理多 Agent 的时候,我开很多窗口,一有 Agent 完成任务了我就切过去看,很快证明这样马上就会乱成一坨
多 Agent 管理必然是异步沟通的方式,这有点像是 CPU 的时间片切换,不应该一有消息就马上切,而是 Agent 异步通知 → 我看到通知了 → 等我把手头的一个检查点工作做完 → 再切过去接收
Agent 永远是在挂起等我反馈,而我只有做完当前“线程”的阶段性事务才会切我的注意力过去
目前我的窗口极限大概就3-4个,这和当前 AI 的长程能力也息息相关(如果未来Agent可以按天高质量交付了,这个窗口数就能扩大)
4. 反模式:单任务不要过大
按照当前的前沿模型能力,我认为单任务最长控制在小时级别是合适的,到天级别很容易跑歪
之前我跑了一个几天的长程任务,跑完发现一堆问题,最后还是不得不全部回滚了
这还是上面说到的原因:当前最前沿模型的能力,我的感觉还到不了天级别
上下文窗口、幻觉、自动压缩、指令遵从性等等,会让 Agent 在长程任务上的问题会逐渐放大到不可控
---
以上就是我在管理多 Agent 上的一点经验,欢迎讨论下:你现在能控制几个 Agent ?每个的平均时长是多少?如何把控质量?

多 loop 或者说多个 Agent 自己执行任务自己验证,这种方式会成为趋势的,原推说的这些问题都存在,但都不是障碍。
这很像一个人从一个 IC(独立贡献者)晋升为 Manager,必经之路就是要学会多线程工作,把任务拆分,交给几个不同的员工去完成,然后并不是活交出去就可以当甩手掌柜不用管了,在这过程中还要不断对齐方向、提供支持、验收、合并,出问题了还要背锅。
之所以说会成为趋势,是因为人的注意力是稀缺的,而 Agent 执行任务是异步的要消耗时间的。
我日常交给 Agent 的任务平均半小时左右,甚至更久,这意味着一个任务给 Agent 后我要等一段时间才能看到结果,如果这期间我一直等着,那是低效的。
所以要充分利用人的效率,就要多开任务,让 Agent 同时做几个任务,这样我可以一直要去分派任务,去验证结果。
就算你要摸鱼,你的老板也不会让你闲着的,最终必然是每个人都被迫从 IC 转型 Manager,只是管的是一堆 Agent,每个人都要多 Loop。
如果你现在还不需要这么做,那么好好珍惜、多多摸鱼,这样的好时光不会持续太久。
之所以说原推说的问题都不是问题。
1. Agent 已经具备纠错能力,只要有合适的工具就能做很多验证的活,coding 自不用说,就连视频剪辑这种事,Agent 都能截取连续帧图片放在一起,借助多模态能力去分析。
2. Agent 也能自己检验和修正错误,只要提供验收的标准和检验的工具,Agent 就能不知疲倦的自我修正。
---
至于和使用者预期不一致,这是无法避免,但不是问题,所以要人工介入去调整。
而且你管理 Agent 方法也很重要,就像好的 Manager,不会等到项目 Dead Line 到了才去看员工任务进展怎么样了,一定是一开始就要通过文档、原型、设计去反复对齐避免理解出错,中间要设置小的里程碑防止走偏。
管理 Agent 也是类似,前期让 Agent 做 Plan、写文档就是为了保证 Agent 理解了意图,后面的验收也是避免结果不是想要的。
让 Agent 干活和人干活有个很大的不同,人做事太慢,时间成本其实很高,同样一个功能,以前人做至少周为单位,现在 Agent 是以小时为单位甚至更小,这意味着犯错的成本同样低。
就算 Agent 做错了有什么关系,让它重做并不是什么大的问题,更何况大部分时候不需要推翻重做,只要小的调整就可以了。
使用者直接、频繁的介入,要耗费大量的注意力会是常态,这是 IC 变成 Manager 的代价,我们再难回去当年 IC 单线程做事的快乐了。

看了下 GPT-6.1 Terra 的性价比,完全比不上 6.1 sol
在 AA 上,相同打分档位下,比如 6.1 terra max vs 6.1 sol medium
单任务平均成本 terra max 是 sol medium 价格的一倍
甚至 sol xhigh 的单任务成本都比 terra max 要高🥲

pi 的 codemode 做的真不错,类似下图这种很多读文件的场景,如果没有 codemode 就需要工具调用往返很多次,既浪费上下文又拖慢性能
codemode 会动态写一个 js 脚本在沙箱批量执行,中间结果不暴露给主agent,只把最终结果返回
现在感觉越来越喜欢 pi 了,其他 harness 没有给我过这种感觉(我指的是可定制性和性能)

nodejs 也爆出安全漏洞了
如果你的 node 版本低于以下版本需要尽快升级一下
Node.js v22.23.4
Node.js v24.22.1
Node.js v26.12.1

🔐 Node.js security updates are now available!
New releases for Node.js 22.x, 24.x & 26.x address multiple vulnerabilities, including high-severity issues.
Review the details and update your systems to stay secure.
🔗 nodejs.org/en/blog/vulnerabi…
#NodeJS #Security

我的时间线上居然刷到高市早苗对php重大安全漏洞的公告😂
用 wordpress 的同学要赶紧升级一下,不能仅升级 wordpress ,得升级 php 版本

皆様に、今夜に対応して頂きたい大至急のお願いです。
多くのウェブサイトで使用されているPHPに関し、PHPのセキュリティチームが、重大な2件の脆弱性に関する注意喚起を行っています。
公開しているウェブサイトでPHPを使用しているか確認し、今夜、10月21日午後11時(日本時間)に公開される修正パッチについて、可及的速やかに適用できるよう準備をお願いします。
修正パッチを速やかに適用することが困難な場合は、例えばウェブサイト等を一時的に停止させることも、リスクを低減させるための有効策の一つと考えられます。
国家サイバー統括室のXアカウントでも関係する情報を発信していますので、そちらも参考にして下さい。
国家サイバー統括室(注意・警戒情報)(@cyber_forecast) / X


如何构建足够健壮、有效的自动化智能体?
Anthropic 的这篇文章给了我们一个模版和工具,我提取出 8 点核心设计思想:
1. 清晰的系统边界:数据源 / agent 沙箱 / 发布目标 / 记忆系统 / 定时任务 / 安全护栏 。各模块职责分离,按读写权限控制系统输入、输出范围
2. 凭证与 agent 沙箱分离:凭证(vaults)保存在独立的可信凭证库中,agent 沙箱内部只能看到凭证占位符,通过指定的工具和白名单访问凭证
3. agent loop 是一个定时任务,下一次启动时如何保证读取的数据源 "恰好" 与上一次接续而不丢不重?它不以固定时间窗口来读取数据,而是通过一个 bookmarks.json 来记录每个数据源的最后成功读取时间。这样每次接续窗口会根据上一次的任务执行情况自动收缩
4. 失败处理原则:不隐藏失败、不中断整体执行。失败会在输出简报中明确告知用户,同时单个数据源失败不阻断整体执行
5. 记忆系统的写入时机:只有在发布成功后才会将标识成功的标记写入记忆,并通过补偿规则来保障发布不丢不重(分布式系统中的 exactly-once 问题)
6. 配置和执行分离:agent.md 用来维护一份包含 模型、提示词、工具 的配置;deployment.md 维护部署配置;preferences.md 维护可变配置项等
7. 读写分离和权限:preferences 对于 agent 只读,state 对于 agent 可读写
8. 设计护栏:所有的外部输入都应默认不可信,以避免提示词注入风险。通过有限的读写权限控制、以及额度保护,控制最坏情况的底线可控(这里我觉得还可以设计的更安全些,比如引入 system one 系统做执行前的门控)
从以上的 8 点设计思想可以看出,设计一套健壮可靠的智能体自动化流程,更多的是整体系统架构和边界设计(更偏 harness 层面),而不仅仅是 单个模型/skill 层面的调优




**形式化验证的基本概念**
形式化验证(Formal Verification)是用数学方法证明一个系统(软件、硬件或协议)是否满足某些属性,而不是像传统测试那样只检查有限的输入案例。
核心思想是:
- 你先用形式化语言描述系统的行为(状态、转换)以及你期望的“不变式”(invariants,即必须始终为真的属性,例如“不会死锁”“余额总和始终为零”“不会出现未定义行为”)。
- 然后用工具(模型检查器、定理证明器或类型检查器)进行数学证明或穷举探索所有可能的执行路径。
- 结果要么是“证明通过”(在指定范围内属性始终成立),要么给出反例(找到一个违反属性的具体路径)。
它主要关注两类属性:
- **安全性(Safety)**:坏事永远不会发生(例如不会越界、不会溢出、不会进入非法状态)。
- **活性(Liveness)**:好事最终会发生(例如请求最终会被响应)。
与测试相比,形式化验证能覆盖所有可能情况(在状态空间可管理的前提下),但历史难点在于建模成本高、证明难写、且容易与实际代码脱节。推文中提到的新工具正试图降低这些门槛,让 AI 代理也能借助它写出更正确的代码。
**推文中提及的方式及其支持的语言**
推文重点提到了三种方式:
1. **TLA+**
这是 Leslie Lamport 设计的规范语言,专门用于建模并发、分布式系统和状态机。它本身不是编程语言,而是独立的规格语言。你用它描述系统“应该如何行为”,再用 TLC 模型检查器或证明系统验证属性。
**支持范围**:语言无关。你可以建模任何语言实现的系统(Java、Go、Python、C++ 等),但验证的是设计/规格层面,而不是直接检查具体实现代码。适合发现并发、协议、状态机相关的逻辑 bug。
2. **Kani**
这是专门针对 **Rust** 的模型检查器。你在 Rust 代码中直接写证明 harness(类似测试,但用 `kani::any()` 表示任意输入),它会自动检查未定义行为、panic、整数溢出、自定义断言和函数契约。
**支持语言**:**仅 Rust**。证明代码就写在 Rust 文件里,不需要另起一套独立语言。特别适合验证 unsafe 代码块和关键正确性属性。
3. **Bend(Bendlang)**
这是一个完整的编程语言(语法接近 Python,带有依赖类型)。你直接用 Bend 写程序,同时在 `LAWS.bend` 中声明“法则”(laws,即必须始终成立的属性),证明写在类型系统中。编译器会机械地检查这些证明是否成立。
**支持语言**:**Bend 本身**。代码即规格,证明即代码的一部分,没有独立的建模语言。它还支持高性能并行和 GPU 执行,目标是让 AI 生成的代码能通过数学证明保证正确性。
总结来说,推文中的技能是一个“元技能”,可以根据你想验证的特性(例如并发状态机、Rust 未定义行为、或 Bend 的法则)自动生成相应的验证套件。TLA+ 更偏高层设计建模(语言无关),Kani 专攻 Rust,Bend 则是自带证明能力的编程语言。

pstack v0.15.27 ships with a new skill /create-formal-verification-skill!
it's still in beta, and similar to /create-verification-skill, this is a meta-skill that creates a new skill and formal verification suite based on the characteristics you want to verify. for example, you may want to model state machines and systems with concurrency using TLA+, or use kani in rust to check for undefined behavior.
if you're new to formal verification, think of it as mathematically proving properties and invariants (something that must always be true) or "laws" of your system. usually, this means modeling your programs in a separate language like with TLA+ and then running the solver on that spec. newer approaches like with kani and @bendlang take a different approach where there is no separate language: you write kani in rust, and bend in bend (it's also a programming language, and the proofs are written as laws and expressed in its type system).
historically formal verification never reached mainstream status because of the difficulty in modeling and writing proofs. it's quite difficult to model your business requirements and keep them in sync! but i expect that we will see more innovation in formal verification in the future as being able to formally verifiy that the code does what you intended gives your agents superpowers in writing correct software.
in the meantime though, i've been experimenting with modeling our code with TLA+ and have already found several bugs with the skill created by /create-formal-verification-skill.
try it out and let me know how it goes!