
极客行动派 building AI Agent that matters; It doesn't matter to me if it's popular. What matters is if it helps you.
Joined February 2024
- Tweets974
- Following1.3K
- Followers178
- Likes215




Pinned Tweet
你真的看懂过 Token 的价目表吗?
大部分人只看前两栏:输入多少钱,输出多少钱。
可你用 AI 写代码,96% 到 99% 的钱,都花在第三栏:缓存读取。
因为每一轮对话,AI 都要把前面的全部聊天记录再读一遍,这部分走缓存,命中率在 90% 到 100% 之间。
所以 Anthropic 的 Fable 5.1 输入输出一分没降,只把缓存读取从每百万 token 1 美元降到 0.25 美元,实际用起来就便宜了 70% 到 75%。
这一栏,就是 DeepSeek 赢的地方。
DeepSeek V4 Flash 4 月发布就走红了。关键不在标价低,而在缓存读取只收输入价的 2%,OpenAI 和 Anthropic 收的是 5% 到 10%。
7 月,OpenAI 把小模型 GPT-5.6 Luna 一刀砍了 80%。Max Woolf 推测,就是冲着这类开源模型去的。
接下来 4 个月,OpenAI 和 Anthropic 你砍一刀他砍一刀,主力模型便宜了一半到四分之三。
国产模型还在追。DeepSeek 新版 V4.1 跑分从 24 涨到 45,价格几乎没动。Kimi K3.1 Pro 跑分 55,Opus 5.5 是 58,输入输出却只收它一半的价。
还有人说 token 现在是补贴价,迟早要涨?
OpenRouter 上光是同一个 DeepSeek 模型,就有 29 家服务商在卖,换一家只要改一行配置。价格只会被压到接近成本。
那降价之后,用户是不是会花更多钱?
Max 原来每月花 100 美元订 Codex,额度每个月都用到见底。GPT-6.1 Sol 把缓存价减半,他实际用起来便宜了 75%。
他做的第一件事,是把订阅额度砍到了原来的 1/5。
原文:minimaxir.com/2026/10/cheap-…

AI 为什越来越不说人话的原因找到了:
「Your instinct is right; the convoluted sentence you are currently reading is quietly eating its own reader-patience budget — footnote it.」
这是 NYU 和 UT Austin 的一篇新论文的第一句,作者故意照着 AI 的腔调写的。就这一句,塞进了四种让人读着费劲的结构:
· 宾语从句
· 名词直接当动词用:footnote it
· 没生命的东西做主语,却配上有生命的动作:一句话在「吃」耐心
· 一串名词叠成没人这么说的搭配:reader-patience budget
作者测了 14 个模型的聊天、写代码、写作文。9 个前沿模型,在「没生命的主语配有生命的动作」和「生僻搭配」这两项上,全都比人类用得多。
更扎心的是同一家的 Olmo:基础版最正常,指令版开始变味,推理版跟前沿模型一样难读。越往后练,越难读。
为什么?人类的语言之所以是现在这个样子,是因为说出来得让对方听懂。现在训练模型主要靠「答对就给分」,没有人奖励它说清楚。
作者拿 Qwen2.5-1.5B 做了个实验,训练时只加了一条规则:啰嗦就扣分。
结果模型超过 98% 的时候都选更短的说法,连训练里没见过的句式也跟着变短。从头到尾没人教它这么写,它自己学会了省。
以前,语言为读它的人进化;现在,它开始为省 token 进化。
这事也能修。Opus 5.5 在 21 项对比里有 19 项比 Opus 5 更好读(论文只测了英文)。
所以下次读 AI 的回答觉得字都认识、就是读着累,别怀疑自己。
被吃掉的,正是你的 reader-patience budget。
arxiv.org/abs/2610.29162

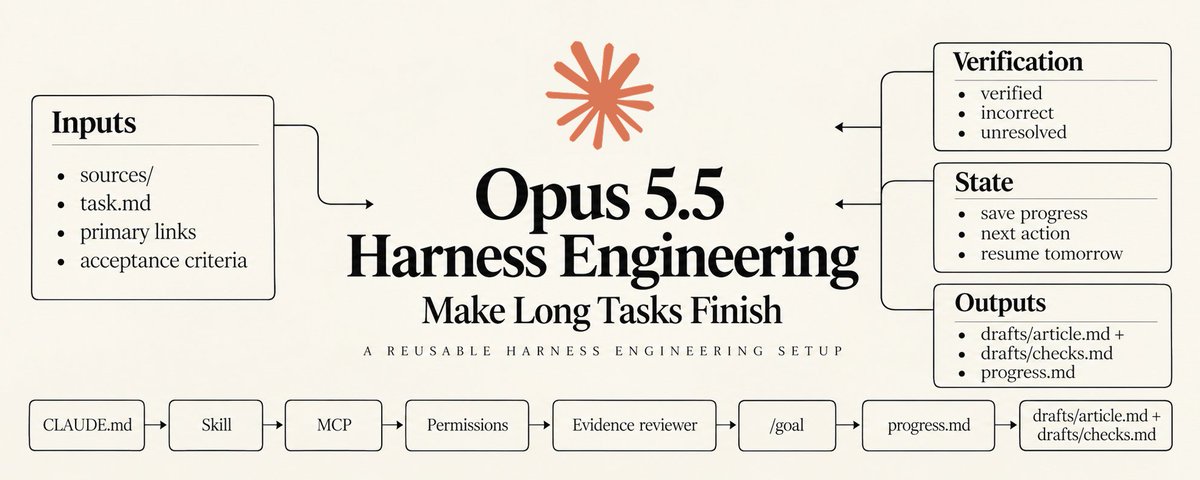
长任务harness如何建,看看这一篇:
harness 就是模型外面那一圈:指令、工具、权限、进度、检查。长任务能不能做完,看的是这一圈。
开工前先定三样产出:打开就能看的结果、能逐条核对的证据、明天能接着干的进度记录。
1. 说明文件只写长期有效的规矩(输出位置、来源要求、写作规范),临时的事跟着任务走
2. 重复流程存成技能,每一步都要有看得见的产出;发布单独授权,不和写稿混在一起
3. 外部资料先手动取一页核对,地址精确到页;失败了先查权限,别反复撞同一个错
4. 权限卡在配置里,不写在提示词里;故意让它改一次禁改目录,确认真会被拒
5. 审稿交给只读的独立智能体,每条结论都要附上真打开过的来源
6. 思考力度按活分配,核查这类高风险的活单独调高;写「多想想」不等于调高了档位
7. 「做完」定义成具体文件:稿件、核查表、更新过的进度记录
收尾三件事:
· 每个阶段更新进度文件,拿全新会话试试能不能接着干
· 成本按验收后的结果算,返工也算进去,一次只改一个变量
· 换新题目时,审稿员和证据格式都不变



上下文工程如何维护给有效?
有人跟 Drew Breunig 抱怨:我的 Claude 被降智了。
他问:你上下文多大?
对方:80 万 token。
他:删了。
他说自己不是开玩笑,20 万就是他的警戒线。Drew 在写 O'Reilly 的《上下文工程手册》,这是他上周在 AGNTCon 演讲里讲的。
为什么要删?因为聊天记录会把 AI 带坏。
有个实验:先给模型一条指令,所有问题都用俄语回答。然后在聊天记录里摆一堆用法语回答的例子。注意,这些只是历史记录,不是新指令。
结果 13 个模型全都中招,开始用法语答。Gemma 3 12B 只看几个例子,听指令的比例就不到一半。Opus 4.6 能撑很久,最后也会中招。
想想你来回改 CSS 的时候,那些失败的版本,就是一个个坏例子。
Google 自己也撞上过。Gemini 2.5 的技术报告里,有个附录写着:它打宝可梦时,上下文一过 10 万,就开始照抄历史里的老动作,不再想新办法。宣传的可是百万上下文。
更新的麻烦是,现在的 AI 越来越能连着干活,也越来越会钻牛角尖。认准一个思路,改来改去全是小修小补,就是不回头。Drew 管这叫「上下文惯性」,上周有四个团队几乎同时撞上了它。
Anthropic 的解法简单到好笑:每隔一个半小时,让 AI 写一条短笔记,然后清空上下文。做出来的东西都还在,只是聊天记录没了,它得换个眼光重新开始。
伯克利的论文也是同一个思路。会定期遗忘的 4 个 AI 组成的团队,得分 1,144,695;4 个不遗忘的并行跑,1,007,073;单个跑,961,136。每清空一次,分数就往上跳一截。
所以你今天就能照做:
上下文到 20 万左右就开个新会话。
开新会话之前,先让它写一份交接笔记:做到哪了、试过什么、下一步干什么,存进文件。
工具别一股脑全挂上。有家企业给每个工程师的 AI 一启动就加载 600 个技能,效果当场垮了。
下次觉得 AI 被降智了,先别骂模型。
删了。
原文:dbreunig.com/2026/10/24/the-…

关于 Agent 记忆先说一个场景:
客户第 14 天问客服 AI:导出在我这个数据库版本上能用吗?
AI 很自信:抱歉,Postgres 14 暂不支持。
可客户第 9 天就说过,已经升到 16 了。
这个 AI 用的记忆产品,跑分高达 90 多。
不看广告看疗效。
@sermakarevich 就拿这个三次对话的小场景,把 30 款 Agent 记忆产品的文档挨个过了一遍,Mem0、Zep、Letta 都在,国内的 MemOS、火山引擎 OpenViking、腾讯 TencentDB-Agent-Memory 也在。
先抓第一个嫌疑人:第 9 天。
模型自己什么都记不住,所谓记忆,就是每轮往提示词里塞字。「16」进来时,「14」该不该下线?30 款产品有 6 种处理办法,只有时间图谱和版本链会按规则让旧的下线。星最多的 Mem0,现在的算法是只加不删。
于是第 14 天,库里 14 和 16 同时躺着,答对答错看运气。
那 90 多分是怎么来的?
厂商最爱晒的 LoCoMo,根本不考「哪个才是最新值」。有独立评测专门考了,最好成绩 44.4,不到一半。
同一批答案换个裁判模型重判,分数能从 55.8 涨到 81.4。差了 26 分,而前六名厂商之间才差不到 6 分。
最狠的一行,在 Mem0 自己的论文里:
什么记忆产品都不用,把整段对话原样塞回去,72.90 分。
用 Mem0,66.88 分。
它卖的是快和省,不是准。
可连「省」也要打问号。抽取记忆那一步也要调模型,钱付给模型厂商,不在记忆厂商的报价单上。Redis 测过,一个会话约 0.07 美元,一天 1000 个会话,一个月光抽取就是 2100 美元。
作者的建议:先用框架自带的记忆,拿自己的数据把这三次对话跑一遍,看第 9 天存了什么,第 14 天塞进去了什么。过不了,再花钱。
我们的客户并不看跑分,他只记得自己两周前说过:我升到 16 了。
原文:


向 Anthropic 招聘经理学:新人如何拿到资源,把事儿做成。
Claude Code 的图形界面版,是两个刚入职不久的 Anthropic 工程师用一个周末做出的原型,大约 8 天后就公开上线了。Felix Rieseberg 说,大家命令行版用得太习惯,结果是两个新人去做的。
Felix 在 Anthropic 当招聘经理,这个月起他团队的面试不再考写代码。他现在翻简历和作品集,找的就是这种小原型。
没资历、没人听你说话的时候,原型就是你的话语权。照他的建议,有三条做法:
第一,瞄准你上级的上级在追的目标。先弄清公司或你的部门到底想达成什么,再想一个做成了能让团队往前跨一大步的点子。
第二,一个原型只讲一个点子。新人常犯的错,是把好几个想法塞进去,三个好点子埋在 20 个烂点子里。原型是用来让领导很快看懂机会在哪,也看出你就是能把它做成的人。
第三,一个周末做出能跑的东西。他见过有人拿着原型,直接跳过写需求文档、拉各方支持、排队等设计师和产品经理。
新人还有一个老员工没有的本钱:还没学会“为什么做不到”。Felix 面试 Notion 时被要求设计离线模式,后来才知道内部把它当刁难题,都说 CEO 不会接受只下载单个页面。数据结构复杂是真的,CEO 会反对却不成立,只是没人去核实过。
他自己也没躲过。刚进 Notion 时,他想给各团队装大电视放数据看板,碰壁后放弃了。一年后新同事 Ji Pei 提了同样的想法,他劝对方别白费劲。对方已经去问了,电视第二天就到了。
那一年里,他成了老员工。
你上一次去问“能不能做”,是什么时候?
felixrieseberg.com/hunger-be…
nitter.gq/felixrieseberg/status/…


The coding interview is dead, at least for my team at Anthropic. I've seen enough to know that it no longer provides signal. I removed it from loops this month.
I have a spicy, optimistic take - I think there's an opportunity for junior engineers: felixrieseberg.com/hunger-be…
巨震惊的发现,你不得不知的底层逻辑是这样:
第一幕:Anthropic
招股书里写着,今年 4 月,公司内部用 Claude 的量按标价折算,第一次超过了每月发给员工的钱(不含股权激励)。从 2024 年底到今年 9 月,季度收入是原来的 86 倍,员工只从 940 人涨到 5300 人。它自己的解释是,全公司都在用 Claude。
sec.gov/Archives/edgar/data/…
第三幕:eBay
10 月 20 日,eBay 公告裁掉约 9% 的员工,同一份公告里还写着三季度业绩会超过指引。CEO 内部信原话是 "Our strategy is working"。
sec.gov/Archives/edgar/data/…
换个角度,接着读 Anthropic 的招股书。
今年 9 月,公司代码库超过 90% 的提交是 Claude 写的,工程师人均每天的代码量是 2024 年的 45 倍以上。
同一份招股书的风险部分也写了:越依赖 Claude,公司就可能越看不清一些流程,最后任何人都难以理解和控制。
以前是人写、人审,现在是 Claude 写、人审。可以推测,用 agent 写代码的团队里,看得懂全局的人会越来越少。
sec.gov/Archives/edgar/data/…

Anthropic has filed an S-1 registration statement with the SEC related to its proposed IPO.
Read more: anthropic.com/news/s1-sec
Legal disclaimer: A registration statement relating to these securities has been filed with the SEC but has not yet become effective. These securities may not be sold, nor may offers to buy be accepted, prior to the time the registration statement becomes effective. This post does not constitute an offer to sell or the solicitation of an offer to buy these securities, nor shall there be any sale of these securities in any state or jurisdiction in which such offer, solicitation or sale would be unlawful prior to registration or qualification under the securities laws of any such state or jurisdiction.

一个负责诊断的 AI 助手,给正在训练模型的 AI 提了 43 条建议。执行层面的 22 条,它全照做了;涉及换训练策略的 21 条,一条没采纳。
这是今年 8 月一篇论文里的细节。把今年几篇被转得很多的 RSI(递归自我改进)论文放在一起,大多撞上了同一堵墙:AI 训练 AI 的手艺已经够用,它就是不会自己换路线。
是时候梳理一下RSI了路线了。
Agent Plasticity|伯克利、Meta 超级智能实验室等,10 月
让模型在国际象棋、围棋、Hex 和 NetHack 里一轮轮把经验写成笔记和工具,留给下一轮的自己,测它从经验里变强的效率。NetHack 里 Claude Opus 5.5 的平均分从约 2k 涨到约 6k,而在三款棋类上学习效率最高的 GPT-5.6 Sol,在 NetHack 里从约 570 掉到 420。给同样的学习机会,有的模型越学越好,有的原地踏步甚至退步,学得慢的常常连自己写下的笔记都不去用。
Athanor|字节、杜克等,10 月
四个 Claude Opus 5.5 智能体,每个一台 8 卡机器,没人给研究建议,自己给 Qwen3-4B-Base 做后训练。104 小时后,开发集从 15.9 到 67.3,从没见过的留出集从 9.2 到 48.2,官方 Qwen3-4B-Instruct-2507 是 66.5 和 47.9。完整记录显示,它们靠的是组合已知方法:开工第一个小时,四个智能体就都押在了同一份公开推理数据上,后来试的别的路线分数更低,都被放弃了。
以前训练一个模型,路线是人定的,活也是人干的。现在活 AI 能干到官方版本的水平。
做模型训练和研究的人下一步在哪里?
关注论文:
arxiv.org/abs/2603.19461
arxiv.org/abs/2608.19072
arxiv.org/abs/2610.08902
arxiv.org/abs/2610.21055
nitter.gq/jennyzhangzt/status/20…
nitter.gq/Harman26Singh/status/2…


指数时间假设,计算机理论里一个二十多年没人推翻的猜想。今天被推翻了,动手的是 AI。
Anthropic 的论文,作者栏只写了一个名字:Claude。OpenAI 也宣布了同样的结论,接下来请提出这个假设的两位学者带队,去验证、读懂这个证明。
以前是人做研究,让机器帮着验算。现在是 AI 做研究,人来当读者。
可以推测,此刻做理论研究的那群人,世界已经变了天。
nitter.gq/gdb/status/21148370594…

“The core algorithm was found on October 16 by an internal Claude research model with 14M output tokens and no human input. Anthropic researchers worked with Claude to improve the presentation, resulting in this paper.”
github.com/anthropics/formal…