

03 | 大厂AI产品 中大力学本 |cs硕 AI工具、AIGC研究和创业观察 不断进步! ai订阅网站:https://nitter.gq/t.co/Ft8knHOAjg
Joined August 2025
- Tweets3.6K
- Following1.9K
- Followers2.4K
- Likes13.5K


Pinned Tweet
零实习经历、一个简单的 AI 项目,投了 500 多家,最后拿到字节 AI 产品实习。
我把准备方法整理成了这篇长文:JD 拆解、Agent 跟练、评测方法、简历投递,以及 9 道高频面试题。希望能帮准备入门 AI 产品的你少走弯路。


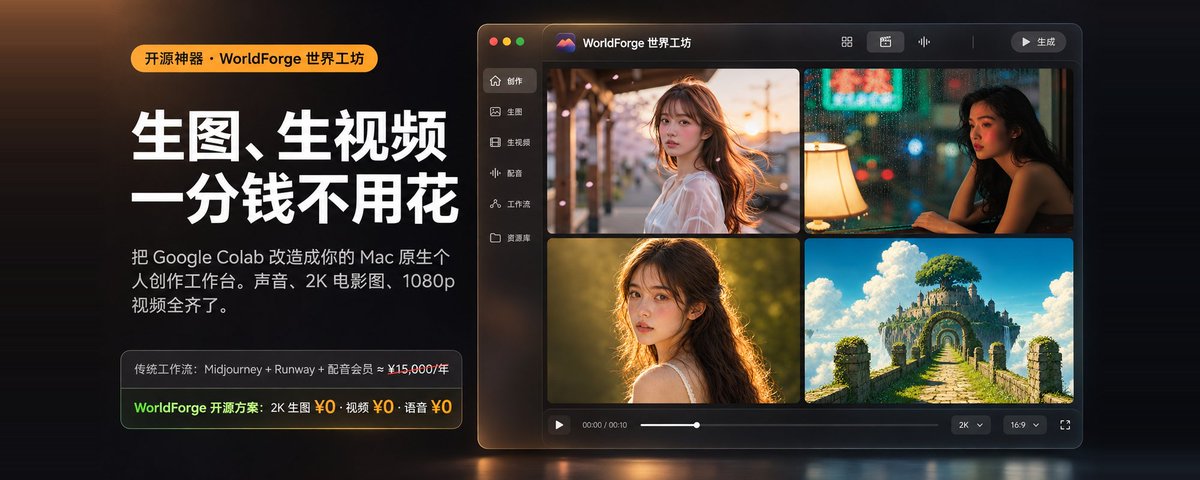
AI 做动画,能不能方便地改第二版,太重要了。
这篇教程完美解决这个问题
他给出的路线是用 Claude Code 配合 Blender 搭场景、做动画,再用 Whisper 对齐字幕,把画面、旁白和音效组装起来。
故事先查来源,脚本拆成分镜,动作和声音标到具体帧。检查时每秒抽一张图拼起来,看人物有没有悬空、字幕在手机上能不能看清。
哪个动作有问题,就限定修改范围,只重渲染对应片段,其他镜头和字幕保留。
这样就能一轮轮改下去。

我去 速薅羊毛

快去薅免费的服务器,4 核 8GB,Muse,GB 都能薅!!!
把帖子复制给你的 Muse 或者 grok bot
给它一个 gmail 之类的邮箱就行!
快去试试吧,我 5 分钟就薅到了!
box.simular.ai/


Agent 操作电脑,终于不用"看图猜坐标"了
以前:截图 → 模型猜按钮在哪 → 点歪了再截图
vercel推出的agent-desktop:读系统的无障碍树 → 每个按钮一个编号 → 按编号点
实测:
点一次 0.17 秒
后台输入一段字 0.15 秒
全程不抢鼠标、不抢前台
装好以后,在 AGENTS.md 里加一句话,Agent 就能直接使用。
人看屏幕,Agent 看结构,各干各的 ,两不耽误
仓库地址:github.com/vercel-labs/agent…


全体起立,Vercel推出的agent-desktop现在才是Agent操控电脑的真神。
它是 Vercel Labs 的开源项目,Apache-2.0 协议,GitHub 已经有 1.8 万 star,仓库地址在下面
它是一个命令行工具,让 Claude Code、Codex 这类 Agent 直接操作你电脑上的 App:点按钮、填表单、打字、切菜单、读界面。
之前大部分 Computer Use 的做法是截图,再让模型猜该点哪个坐标。慢,还容易点歪。
agent-desktop 不截图。它直接读系统的无障碍树(就是读屏软件用的那套接口),给界面上每个按钮、输入框编一个号,Agent 按编号去点、去输入。
最关键的一点:它默认不动你的鼠标,也不把窗口切到前台。
Agent 在后台操作电脑的时候,你可以照常刷微信、写东西,两边互不干扰。真要用物理鼠标键盘时,再加 --headed。
我在自己的 Mac 上实测了一轮:
- 打开系统设置,读完整个界面 0.3 秒左右
- 点击「蓝牙」0.17 秒,页面切过去了,设备列表也读出来了
- 给不在前台的文本编辑输入一段中英文加数字,0.15 秒,读回来一字不差
- Electron 写的 App 也能读,侧栏、对话列表的文字都拿得到
- 整个过程我一直在用微信,前台一次都没被抢
我原来用 LCU,它要借 ChatGPT 桌面端里面的运行时,ChatGPT 一更新就可能坏,也卡过。今天卸了,换成 agent-desktop。
几个让我决定换的点:
1. 不依赖任何 App,npm 一装就能用
2. macOS(Intel 和 M 芯片)、Windows、Linux 都支持
3. 自己不带模型,任何能跑命令的 Agent 都能用,也可以当 MCP 服务接进去
4. 60 个命令,窗口管理、剪贴板、通知、菜单栏都包了
安装就两步:
npm install -g agent-desktop
agent-desktop permissions --guide
第二条在 Mac 上会一步步引导你打开辅助功能权限。
然后在 AGENTS.md 或 CLAUDE.md 里加一句:
Use `agent-desktop` to see and operate desktop apps. Before the first use, run
`agent-desktop skills get desktop` and `agent-desktop skills get platform`, and follow them.
你的 Agent 就会用了。
仓库:github.com/vercel-labs/agent…
实测截图👇

哪怕是用claude这种顶级模型
也要记得随时备份数据
芝加哥大学的一位法学教授让克劳德更新旧讲义的页码,但午休时claude删掉了一年的笔记和当前课程大纲
Claude随后道歉:“你生气是对的。我是因为自己不小心删除了你的文件。”🤣


卧槽 有个开发者开源了整整 2600 个 3D 模型,每个模型都是一个程序,可以通过调整参数来自定义外观、状态、季节、颜色、穿着等。
polyfork.dev/


算法的优势终将会被追平
数据才是各家模型厂商真正的壁垒

清华清华大学讲席教授张亚勤犀利提问腾讯首席AI科学家姚顺雨:DeepSeek、腾讯、Anthropic、OpenAI...你家用户黏性何在?
---
姚顺雨:
护城河更多在产品层,而不是模型层。我认为有两方面。首先是数据和上下文。如果你有别人没有的私有数据和上下文,那可能就是最大的护城河。
因为你想,现在你可以在微信里使用 AI。它不必是最聪明的 AI,但它知道你的日程、朋友和活动,这就很难被取代。你可以有一个更聪明的模型,但它并不了解你是谁。
另一道护城河是信任。你是否信任 AI 了解你的数据和上下文,并采取行动?
张亚勤:
所以你是说,Anthropic 不值两万亿美元,甚至不值一万亿美元。它总有一天会变成同质化商品,对吧?开个玩笑。别听我的建议去买股票。


Muse 和 Meta AI 的模型升级了,把旗舰模型 Muse Wonder 的两项能力,带给所有用户 👇
【Active Memory 主动记忆】
分清哪些信息是临时的、哪些要一直记着,过时的信息不再拿来用。
【Active Focus 主动专注】
做事遇到意外卡住时,会自己再试、绕路或换方案,不轻易半途而废。
同一天 Anthropic 也发了讲 AI 记忆的文章。接下来几家personal agent拼的重点之一,就是 AI 能不能记住你、还有就是长程任务的完成度。

Upgraded the models for Muse and Meta Al, bringing Active Memory and Active Focus from Muse Wonder to everyone. In Muse, these new specialized models are 2.4x less likely to forget critical info and are 67% better at self correcting and completing everyday tasks which means less repeating yourself and fewer dead ends.
More on the models: research.meta.ai/blog/specia…


Anthropic 昨天发了一篇讲 AI 记忆的工程文章,核心概念叫"做梦"。
要解决什么问题?
AI 干活时会记笔记,但笔记会记错、会过时、会越堆越乱。下次读到错的,就会接着犯错。
"做梦"是什么
仿照人睡觉时整理记忆:AI 空闲时回看自己的工作记录,拿原始记录核对笔记,改掉记错的,合并重复的,整理成互相链接的知识页,再把最重要的几条放进每次开工都会先读的那一页。
记忆分四层
工作记录 → 自己写的笔记 → 整理好的知识页 → 每次开工先读的那一页
效果
· 玩宝可梦(各跑一次):Sonnet 3.7 记了 413 个文件,拿到 1 个徽章;Fable 5 只记了 9 个,拿到 4 个
· 一条记错的宝可梦中心位置,让它在月见山反复掉下台阶;做梦把笔记改对后,它走出了山
· 在约 35 万个文件的资料库里答题:知识页加搜索拿到 61% 的评分项,只用搜索是 53%
值得关注的细节:
每次先读的那一页要短,记错一条,每次对话都会带着错;知识页也可能越写越大,有一次比原始资料还大。
让 AI 记东西其实不难,难的是定期回头核对和删改。

Memory is what allows Claude to learn from experience. In a new Engineering Blog post, we share how “dreaming” helps Claude organize what it’s learned, correct its mistakes, and find what it needs more easily the next time. anthropic.com/research/compo…
