

CTO @ Homeo · on construit le dating immobilier Dev FullStack · IA maximizer · Poker crusher ♠️ 4bet light the code · Caen, FR
Caen, France
Joined February 2016
- Tweets4K
- Following323
- Followers662
- Likes7.9K




Mistral a sorti Large 4 hier, surnommé « Le Chonk » :
1 000 milliards de paramètres. Il fait 38 chez Artificial Analysis, GLM 5.3 fait 45.
On n'atteint pas le niveau de la Chine. Mais deux choses me donnent envie d'y croire, et la seconde, personne ne l'a encore vérifiée :
Mes deux raisons d'y croire :
C'est une préversion, Mistral écrit lui-même que son entraînement par renforcement est toujours en cours.
Et la seconde : ils affirment qu'il dépasse nettement les modèles ouverts américains et européens.
Ensuite, ce qui est plus dur à lire :
Kimi K3 fait 44
DeepSeek V4.1 Flash 39
La communauté l'a déjà testé : on le voit perdre contre DeepSeek V4.1 Flash sur un test de la lampe à lave, et antirez trouve DeepSeek meilleur sur DeepSWE
DFintelligence s'amuse aussi dessus...
Il tourne sur un déploiement européen opéré de bout en bout sous droit européen.
L'API est ouverte dès maintenant (1,36 $ en entrée, 4,18 $ en sortie par million de jetons) et les poids doivent sortir d'ici la fin du mois.
D'abord, ce qui me plaît :
Il a 49 milliards de paramètres actifs, il est nativement multimodal, et il a été entraîné de zéro sur 3 800 GPU Nvidia dans les propres datacenters de Mistral en Europe.
J'aime pas trop le terme de '' vibe coding ''
Je pratique plutôt le cuck-coding
T'es assis sur ta chaise à regarder l'action, et tu interviens par ci par là pour donner des instructions
Djé retweeted

Aaah merci @juliencdt de rappeler les ordres de grandeur, et oui la comparaison data centers/terrains de golf (et gazons !) pour le prélèvement en eau, ça marche toujours très bien en effet ⛳️


Opencode qui met en accès free un modèle mystérieux sur la semaine
Les benchmarks qui ont pu tourner le placent en top tier model (frontier), certains scores devant Fable et GPT Sol 5.6
Vous pensez qu'il s'agit de quel provider ? Personnellement je miserais sur le modèle de...

Djé retweeted

God was the first vibe coder.
“Let there be light.”
No design doc. No tests. No staging environment. Just shipped the universe directly to production.
In France we dont need it, we have @KitBul


Djé retweeted

C'est la deuxième fois que Dieu nous envoie un virus pour régler le financement des retraites et qu'on ne saisit pas la main tendue.
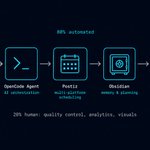
J'ai automatisé 80% de mon community management avec des outils open source. Voici le setup complet.
Avant, je postais au feeling. Un post quand j'y pensais, rien pendant deux semaines, zéro stratégie. Le genre de régularité qui fait fuir l'algorithme et l'audience.
Aujourd'hui, je parle dans mon terminal avec SuperWhisper et un agent fait le reste.
Postiz en self-hosted. Scheduler multi-plateforme (LinkedIn, X, Instagram). Interface propre, API ouverte. Remplace Buffer ou Hootsuite sans l'abonnement.
Un serveur MCP custom qui expose l'API Postiz à mes agents. Créer un draft, lister les posts, vérifier le calendrier. Tout en CLI.
Un skill d'agent dédié "community-manager". Il connaît mon ton, mes guidelines par réseau, mes piliers éditoriaux. Il rédige, je valide.
Un vault Obsidian pour la mémoire. Chaque semaine a son fichier par plateforme. Planning, textes, métriques. L'agent lit et écrit dedans.
Les 20% que je garde à la main : le contrôle qualité des textes, la mise en page, l'analyse des analytics et la gestion des visuels.
Résultat : je passe de "qu'est-ce que je poste ?" à "valide ou ajuste".
Si le détail du setup vous intéresse, dites-le en commentaire. Je ferai un post dédié sur chaque brique.

33 ans. Le Christ s'est arrêté là. Moi je push en prod.
Du bar esport au CTO, la route n'a jamais été droite.
À 23 ans, j'ai mis des PCs dans un bar. Premiers en Normandie à le faire. J'ai revendu après 7 ans, pile au bon moment. Et la vie a enchaîné direct avec une grossesse.
Deux apprentissages en parallèle : le code et la paternité. Les nuits blanches servaient pour les deux. Entre les pull requests et les changements de couche, j'ai pas vu passer 2022.
Aujourd'hui, 33 ans. CTO associé chez Homeo, on construit dans l'immobilier. Le bar, le code, la paternité : chaque chapitre a préparé celui d'après.
Et celui-là ne fait que commencer.

T'écris encore du code à la main en 2026 ?
J'ai commencé avec VS Code. Puis Cursor. Aujourd'hui je n'écris pratiquement plus une ligne.
Mon setup : OpenCode en terminal. Quatre modèles en parallèle, chacun avec son rôle.
> Claude Opus pour la planification et le raisonnement complexe. Sonnet pour l'exploration de code et l'écriture rapide. Codex pour la code review et l'analyse de bugs. Kimi Turbo pour les écritures de fichiers à haute vitesse.
> oh-my-opencode pour l'orchestration. Skills custom, agents spécialisés, workflows automatisés. Chaque modèle est relié à un agent différent.
Le process : chaque feature du backlog est décomposée en tâches par des agents de planification qui analysent le code existant.
Un orchestrateur lance des builders qui codent, testent (unitaires, lint, build), et s'auto-reviewent.
-> Feature terminée = tests auto + validation manuelle + PR.
La PR passe ensuite par 3 cycles de review croisée entre Codex et Opus. Détection de bugs, correction, re-analyse.
> Quand les deux valident, c'est prêt à merge.
Mon rôle aujourd'hui : architecte, reviewer final, product manager. Gestion des sprints, des priorités, de la timeline de déploiement.
> Le travail c'est moins d'écrire du code que d'orchestrer la production de toutes les features en cours.
Et toi, c'est quoi ton setup ? Tu codes encore à la main ou t'as changé de méthode ? Je suis curieux.
Hey @justsisyphus, is it possible for oh-my-opencode to use start-work on multiple different tasks already planned, on multiple terminals and worktree ? Can't seem to work on two plans in parallel :(
Just shipped : Discord-OpenCode Bridge
Control multiple @opencode sessions from your phone via @discord.
Works even better with oh-my-opencode plugin.
Feel free to share and star⭐if you find it useful.
github.com/Jeremie-m/discord…

