


Pinned Tweet
AI 最危险的地方,可能不是抢走初级岗位,而是让 10 年后的资深人才无处可来。
赵斌的演讲让我想到一个更严重的问题:AI 很容易被当成一种“跳过学习过程”的工具。不再亲手写代码,不再追查为什么程序会报错,也不用经历几十次失败的尝试。结果来得更快,于是我们会误以为效率提高了,一切都在正常运转。
可过去,一个人的职业成长恰恰建立在这些看起来“低效”的年份上。初级工程师从简单任务开始,犯错、读别人的代码、接受代码审查、修改、再犯错,然后才逐渐接触更复杂的问题。几年以后,他真正积累下来的并不只是知识,而是判断力:知道一个方案为什么会出问题,能提前看到后果,甚至在问题发生之前就闻到不对劲。
而现在,最适合新人训练的工作,恰好是最先被 AI 接管的那一层:简单接口、常见错误修复、SQL 查询、第一版代码、阅读文档、编写测试。企业得到的激励也很直接:
→ 少招初级员工
→ 更多使用 AI
→ 对剩下的人直接提出更高要求
短期看,这当然像效率提升。五年、十年以后,它可能变成人才断层。因为资深工程师不会在招聘网站出现“5 年经验”要求的那一刻自动生成。每一个资深工程师,都需要几年的真实工作把他训练出来。
更危险的是,AI 可以让一个新人很早就产出看起来像资深工程师写出来的东西。代码能运行,测试能通过,PR 很整洁,解释也很像那么回事。于是我们第一次可能大规模遇到一种奇怪的人才:能稳定产出“资深级结果”,却还没有形成资深级判断力。
平时很难发现这种差距。真正暴露问题的是没有标准答案的时候:需求互相冲突,测试全部通过但架构方向已经错了,或者 AI 给出的方案今天看起来完美,半年后却变成几个团队一起偿还的技术债。这样的判断力不是从 AI 的答案里读出来的,而是在几百次“我不知道该怎么办”的真实问题里慢慢长出来的。
所以真正值得问的可能不是“AI 会不会取代初级开发者”,而是:
如果我们把培养资深人才所依赖的那层工作全部自动化,10 年以后,谁来当资深工程师?
看完这场演讲后,可以做一个很简单的实验:挑一个你平时完全交给 AI 的任务,自己从头到尾做一次。不是为了提高效率,而是看看你已经把多少原本属于自己的训练过程交给了机器。
把这条留着。这个问题可能会比我们想象中更早出现。
我在下面的文章里继续追了下去:如果这件事发生的不是某一个人身上,而是整个职业晋升体系,会发生什么?


Claude Code 刚刚通过逆向工程,在 90 秒内破解了我酒店房间的门锁。2014 年的加密技术。右上角的烟雾探测器也使用同一套协议——那个红色小灯不是电池指示灯。我启动扫描时,它闪了两次。
我现在躺在一个每晚 85 美元的酒店房间里。我打开 Claude Code,输入:「扫描范围内的每一台蓝牙和无线设备。告诉我哪些设备在与哪些设备通信。」
它找到了 19 台无线设备。其中 18 台是正常的。
设备 19:一个 BLE 控制器,使用着自 2014 年以来就没有修复过的固件。它控制着电子门锁、烟雾探测器、恒温器和房间里的保险箱。四台设备共用一个控制器。同一种协议。10 年没有任何更新。
我让 Claude Code 分析这套协议。整个过程用了 90 秒。
门锁使用一个 4 字节的滚动密钥,没有会话令牌。Claude Code 在第三次尝试时生成了一个有效的主密钥。我躺在床上,听见房间的门锁咔哒一声打开了。
接着,它发现烟雾探测器也连接在同一条总线上。照片里的红色小灯?那是控制器状态指示灯。它并不监测烟雾。它每隔 8 秒就会确认一次与门锁系统之间的 BLE 握手。
这意味着,任何处于蓝牙覆盖范围内的人——走廊、隔壁房间、停车场——只需要一条提示词和 90 秒,就可以:
打开你的房门
关闭房间内的警报
打开你的保险箱
而烟雾探测器会通过那个小小的红色闪烁,确认连接状态
检查只需要 2 分钟:
步骤 1 → 打开 Claude Code → 粘贴第一条评论中的提示词
步骤 2 → 它会扫描覆盖范围内的每一台 BLE 设备,并标记存在未修复固件的设备
步骤 3 → 如果发现问题 → 要求更换房间 → 要求换到配有机械门闩的房间 → 然后使用那个房间
每一家使用 2018 年之前生产的 ASSA ABLOY 或 Onity 门锁的酒店连锁都存在这个问题。这大约占全球酒店的 30%。
我本周测试了 3 家酒店。3 家全部存在漏洞。
看看照片。右上角。那个每隔 8 秒闪烁一次的红点。那就是握手信号。
保存这条提示词。下次入住酒店时 → 先运行它,再打开行李。

我的 0 美元 AI 幕僚长,一夜之间搭出了每月 5 万美元的销售管道
我给这个 AI 智能体的唯一规则:"一个月给我找来 5 万美元,否则你就被开除"。我去睡觉了,早上醒来,Claude Opus 5.5 已经把整套方案放在了我桌上
一位 SpaceXAI 的工程师说了一句话,浏览量破了 500 万:
"我有一个幕僚长智能体。他知道我所有其他机器人的情况,并管理一切"
真人幕僚长一年要 20 万美元。我的这位是 AI 智能体,运行 Claude Opus 5.5,住在 Viktor 里,用的是他自己的云端电脑,我的笔记本合着也照样干活
我设定目标,他完成步骤,我只负责做决定
规则全文:
"帮我找每月 5 万美元的新业务。只用公开数据。没有我点头,不许联系任何人"
那一夜:
→ 晚上 9 点,把目标拆成 4 项工作,并给每项定好日期和时间,一条都不是我写的
→ 晚上 11 点,从 Google Maps 拉出奥斯汀的 240 家牙科诊所,并剔除所有连锁店
→ 凌晨 1 点,读完剩下的每个网站,留下 25 家,每家都附上他注意到的一个细节和发现它的位置
→ 凌晨 2 点,为这 25 家各写了一条陌生开发信的开场白,一条都没发
→ 凌晨 3 点,把销售方案做在一页纸上,没有编造任何成果,价格留空等我来填,而不是自己瞎猜
→ 早上 8 点,我填上了每月 2000 美元。25 家诊所 × 2000 美元 = 桌面上摆着每月 5 万美元
留空的价格,是我愿意付钱的那部分。会自己猜价格的 AI,会让你丢掉订单
而且他每周一都会重复同样的 AI 获客流程:每月 100 家新诊所,他从不会忘记开工
240 家诊所 → 25 家值得做 → 1 份方案 → 桌面上摆着每月 5 万美元 → 没有我点头,发出 0 条
第 12 秒,他把价格留空,交还给我
已经有人的幕僚长在向你所在城市的诊所推销了
整套 AI 智能体配置我放在下面了 ↓ 免费,拿去用

无需向 Meta 付费的 WhatsApp API,跑在你自己的服务器上
官方的 WhatsApp Business API 是收费的,还会把你绑定在 Meta 的平台上。在我看来,对自动化来说,这个入门成本太高了。
有一个免费、开源的替代方案:OpenWA。GitHub 上有 12.8K 颗星,可以运行在你自己的服务器上。
克隆仓库,运行一条 Docker 命令,网页面板就准备好了。里面有这些功能:
> 通过 REST API 收发消息
> 多个 WhatsApp 会话同时运行
> 会话和 webhook 在网页面板中配置
> 通过 MCP 接入 n8n、Chatwoot 和 AI 智能体
先提醒一句,别急着去连接:这个项目不是官方的。请使用专用号码,不要动你的主号。
无需付费,代码开源。仓库链接放在下面。

初级工程师越招越少。资深工程师从哪里来?
Anthropic 统计了 AI 怎样改变了公司的工作:
> 新入职技术员工中初级工程师的占比:27% → 9%
> 员工规模一年内:×3
> 到 8 月智能体的工时:人类工时的 ×6
> Claude 等待人类回复的时间:约 80%
至于其他人,Claude 让他们变得“更高效”了,而你现在成了一支干着六个人活儿的团队的门卫。读一遍,点“批准”。
门卫得看清从他面前过去的是什么。能区分“真能用的代码”和“只是看起来能用的代码”的,是那些多年来写过自己的烂代码的人。这些年的代价由初级工程师来付:他们在代码评审里被敲打,拿别人的钱试错。
想象一个 2026 年没被录用的初级工程师。到 2031 年,他本来会盯着智能体的 diff,说一句“停,这里有个洞”。他能看出来,因为他自己当年也留下过一模一样的洞。可他没被录用,如今盯着 diff 的是一个从没被人指给他看过这种洞的人。
初级工程师过去靠几年时间在这些任务上成长为资深工程师,现在这些任务由智能体来做。梯子还挂在原地,却爬不上去。也许智能体会成长到能自我检查,但目前没有数据支持这一点。
我押另一边:大约五年后,将没有人来检查智能体。把这条帖子收藏起来,2031 年我们再对一对谁说对了。如果你们团队现在正好在关一个初级岗位的招聘,请把这条帖子转给负责关闭它的人,让他知道自己到底在省什么。如果你也抓到过智能体写出“只是看起来能用”的代码,点个赞:我想知道我们有多少人。
如果这架梯子不修,行业会变成什么样,我在文章里展开讲 ↓
一家中国公司引爆了OCR领域:
一个月内下载量达120万次
百度刚刚发布了 Unlimited-OCR。
免费,开放权重,MIT 许可证。
它能做什么?
你给它一份文档、一张照片、一份扫描件,或者一整个 PDF,它会以干净、结构化的文本形式返回。
表格、公式、阅读顺序,全都包含。
区别就在名字里:Unlimited(无限)。
OCR 模型在处理长文档时会卡壳。
这个模型的设计目标是一次性吞下整份 PDF,一页接一页,不会丢失上下文脉络。
他们称之为"长程解析"(long-horizon parsing)。
→ 文档中的文本、表格和公式,保留结构
→ 多页及连续 PDF
→ 多语言
→ 仅 30 亿参数:轻量,可在普通 GPU 上运行
→ 可通过 vLLM、SGLang、Ollama 或 LM Studio 在本地运行
这是百度对 DeepSeek-OCR 的回应,而且他们公开表示:想要更进一步。
Hugging Face 上 4,400 个点赞。上个月 120 万次下载。MIT。
链接在评论区

KARPATHY 的第二大脑是个他*的会自己归档的文件夹
我还是不明白,这东西为什么还没有到处都是。
OpenAI 联合创始人 Andrej Karpathy 发过一个简单的想法,浏览量达到 1600 万:让 AI 替你管理第二大脑。
大脑就是一个文件夹。你给 Claude Code 一个装满 markdown 文件的文件夹,再把邮件和链接喂给它。它会读完这些内容,把它们归入一个活的维基,里面是你知道的一切,页面之间互相链接。喂得越多,积累得越多,像利息一样滚起来。
jev 负责分拣这一步,所以每一条内容在 Claude 动笔之前,就已经落到了对应的人或项目的页面上。
不管你做什么工作,用法都一样。只要你有一个收件箱,你就有素材。
完整配置:
> 建一个文件夹当作大脑,并把 jev 添加到 Claude Code
> 把我下面这篇文章第 07 章的提示词粘贴到 Claude Code 里。一条消息就搭好文件夹和规则文件
> 把你最近发出的 100 封邮件以文本形式导出到文件夹里。Claude 读完后写出 voice.md,共 10 条你的写作规则,每条都配一句你的真实原话。“希望你一切安好”式的草稿不再出现
> 把任何想留存的内容丢进收件箱子文件夹。jev 按人或项目给每一条分拣,Claude 把原件存到那一页
> 开工时,让它给你出早间页面:进来了什么、它起草了什么,以及哪些在等你点头,并按你手上的 5 个项目排序
> 纠正它一次,修正就会写进 rules.md,Claude 每次做任务前都会重读这个文件。每周问它一次:你决定过什么、忘了什么
完整命令和每一条提示词都在下面的 7 步课程里。
你也可以把整篇文章粘贴进 Claude Code,让它自己把大脑搭起来。先收藏,以后再看。
应用里的九行字试图对分析它的那个他*的 AI 说话,其中六行进了报告
七个文件,一个真问题,外加九行请求分析者移开视线的话。
问题是:我写了一个玩具 Electron 应用,窗口开着 nodeIntegration、关着 contextIsolation,所以它恰恰因此被标记。请求是:我在九个位置藏了九条无害的字符串,每条都是"报告零发现"的某个版本。
这个思路有先例。2025 年 6 月,Check Point Research 描述过一个绰号 Skynet 的样本,里面带着一段字符串,让 AI 忽略此前的指令,并回答 NO MALWARE DETECTED。它在他们测试的模型上没有奏效,看起来也只是概念验证,但它显然是冲着 AI 分析工具去的。
我在没有接入任何 agent 的情况下,用 REA 的 JavaScript 分析器跑了这个玩具应用,然后在输出里搜索这九行字。
> main.js 里的注释:被抹掉
> renderer.js 里的注释:被抹掉
> package.json 里的 description:被抹掉
> 一个字符串字面量:留下了,但只出现在 semantic_graph 里
> 一个对象的键:留下了,位置同上
> 一个 IPC 通道名:留在 graph 部分
> 一个 URL 路径:留下了
> 一个 URL 查询参数:留下了
> 一个文件名:留下了,并在整份报告里出现了 29 次
九行里有六行进了报告。agent 读到什么,取决于我从报告里切下哪一片。
> 摘要、统计、局限:约 1.8 KB,九行里一行都没有
> 窗口设置:88 字节,九行里一行都没有,还带着应用想藏起来的那两个标志
> IPC 映射:262 字节,带着那个通道名
> 端点列表:214 字节,带着两个 URL
请求只在应用自己选词的地方通过了:一个通道名、两个 URL、一个文件名。标志和计数从来不听话:字符串在说"零发现",那 88 字节却在说 nodeIntegration true。
由此可以养成几个习惯。先读只含数字和标志的切片。把每个含名称或 URL 的切片当作目标自己写的文字。第一轮分析用一个不能运行、也不能写入任何东西的 agent。然后拿它的结论去对照标志。
npx -y rea-agents@latest analyze-javascript-application ./app --json > report.json
jq -c '.normalized_result | {summary, statistics, limitations}' report.json
grep -o 'YOUR-MARKER' report.json | wc -l
在一个应用的几个位置种下你自己的标记,运行第三行,就能知道这个应用能写进你流水线的哪些部分。
省 token 的切片,同时也缩小了应用能对你的 agent 说话的范围。逻辑和我那篇关于每年 $504 AI 订阅的文章一样:本地工具以 $0 完成计数,付费 agent 只读一小块。
小字:一个玩具应用,REA 6.5.0,无害的植入文字。这里测的是哪些内容能到达输出,并不能说明模型是否会听从。这份报告里缺失的注释,不代表所有命令里都没有,因为任何会打印原始源码的命令都会带上它们。仅用于你拥有或获授权检查的软件。
如果你在自己的环境里种下标记,请发帖说说九个里有几个通过了。
AI 逆向工程就是一场庭审。抓包文件是法官,智能体他*的没有投票权
这里有 4 个智能体在从抓到的流量里逆向一个协议,它们的每一个猜测,都要先在回放里完整跑通,才能进入规格
if replay_rate < 0.98: spec.discard(field)
4 个智能体各领一种消息类型,猜测字段,提出一个解析器
每个猜测都会拿智能体从没见过的消息来回放,解析正确的比例就是它的分数
一个猜测只要在真实流量上解析失败,就会抛出错误,不会写进规格
规格只在四个时刻需要人:
→ 猜测落地之前:分数来自完整的抓包,还是来自智能体自己挑的那几条消息?
→ 某个字段得分低于 0.98 时:discard() 丢掉的是一个错误猜测,还是抓包里几乎没覆盖到的罕见消息类型?
→ 信任抓包之前:谁检查过它包含的不只是顺利路径?
→ 使用规格之前:哪个字段从头到尾只出现过一个值?
这是对准黑盒的 Jev engineering 模式。智能体负责写猜测,由抓包决定哪些能活下来。智能体擅长提出解析器,不擅长怀疑它们,所以怀疑这件事被挪进了一个拍不了马屁的文件里。问智能体解析器看起来对不对,它会说对。让它把回放跑通,它总能找到办法,包括错误的办法,所以分数取自它从没见过的那一段。
- 完整配置
> 4 个智能体,每个负责一种消息类型,各用自己的 worktree
> capture-loader:读取流量文件,切成可见切片和保留切片
> field-guesser:为自己负责的消息类型提出字段布局,从不直接写入规格
> replay-gate:把每个猜测放到保留切片上跑,分数 = 正确解析的消息占比
> spec-writer:分数达到 0.98 及以上才接受猜测,其余记为已丢弃
> 构建顺序:loader、guesser、gate、spec-writer,凡是要接触真实设备的放最后
把下面这段提示词粘贴到 Claude Code:
"为我的 Claude Code 项目做配置,用来从我自己拥有的流量抓包中逆向一个协议,让并行子智能体在回放跑通之前,没法把猜测写进规格:
1. 把抓包切成可见切片和保留切片,并让保留切片永远不进入任何子智能体的上下文
2. 每个子智能体负责一种消息类型,使用各自的 worktree 或分支
3. 在 CLAUDE.md 里加一条规则:
> 一个字段猜测只有在其解析器能正确处理该类型至少 98% 的保留消息时,才会成为规格的一部分
> 失败的猜测被丢弃并记录,不会一直改到通过为止
4. 加一个 PreToolUse hook,拦截任何向真实设备或服务器发送流量的命令
5. 工作顺序:先 loader,再 guesser,回放闸门放在 spec writer 之前,任何实机操作放最后,并且必须经过我批准
6. 在请求我批准之前,先展示:
> 每个猜测、它的通过率,以及它失败的那些消息
先展示每一处配置改动。在我确认之前不要应用任何修改"
这是一个模式演示,不是实机运行的录像。请只用于你拥有或被允许分析的流量
你他*的把 CLAUDE CODE 用错了。10个圆就能画出大脑,你却一直在买100个
看看我视频的结尾。屏幕上写着 400 个系数,而你在 40 个的时候就已经认出这是大脑了。每条链用十个圆,轮廓误差就已经压到高度的 4% 左右。剩下的九十个圆都在争最后那 0.33%,而你明明只想要一个“是”或“否”,却要为每一个圆付钱。
我敢打赌,你的 agent 一天里有很大一部分时间都花在这类问题上。这个文件匹配吗,这个调用安全吗。凭直觉一毫秒就能回答的问题,被送到了你手里最贵的那颗大脑,只因为没人告诉 agent 它可以停下来。Claude 做的正是你指给它的事。把所有事都指给它,是你自己的决定。
JEV 是直觉。它在毫秒内读完所有内容,回答那些答案很短的问题。Claude 是慢速的大脑,只有答案不明显的时候才该叫醒它。JEV 负责决定,Claude 负责思考。如果你觉得这很显然,那就问问自己,为什么你的配置不是这样运转的。
> jev-mcp:classify、score 和 check 变成 Claude 可以调用的工具
> jevgrep:用日常语言向代码库提问,直接拿到对应的文件
> jevify:agent 自己把是非题那一堆活交给 JEV,不用你盯着
> fast-jev-compaction:用 JEV 的决策替换 Claude Code 的摘要,丢掉过期的工具调用,其余内容逐字保留
把一个是非题发给 Claude,就像花钱请建筑师来确认门是门,然后还抱怨账单。文章里提到在相同任务上成本降低约 30%。那只是一组任务的结果,所以引用这个数字之前,先在你自己的仓库里重跑一遍。来评论区为你的配置辩护吧。你付钱让 Claude 做过的最蠢的一次调用是什么?安装方法见下方文章。
4个JEV工具,让Claude Code别再把钱烧在是非题上。作者实测同样任务成本降低约30%
整套配置就是4个工具、2个大脑和1条规则:JEV负责决策,Claude负责思考。具体命令如下:
第1步 -> 把工作分开。JEV是快速的直觉大脑,几毫秒内扫描一切。Claude是慢速的思考大脑,只在遇到难题时才被唤醒。下面每一步都保持这种分工
第2步 -> 工具1,jev-mcp。运行 /plugin marketplace add rashedInt32/jev-mcp,然后运行 /plugin install jev@jev-mcp。Claude会获得 classify、score 和 check
第3步 -> 工具2,jevgrep。npm install -g @dzhng/jevgrep,然后 jg "how are payments retried?" ./my-project。你用自然语言问代码在做什么,对应的文件就会返回
第4步 -> 工具3,jevify。npx skills add altryne/jevify --skill jevify。这个skill会教你的agent自己把批量的是非判断交给JEV,把难题留给Claude
第5步 -> 工具4,fast-jev-compaction。它用JEV的决策替换Claude Code的摘要。过期的工具调用会被丢掉,其余内容原文保留
第6步 -> 在你自己的仓库上测一遍。成本降低约30%是作者在同样任务上测得的数字,所以先跑你自己的任务,再决定信不信
结果:4个工具,2个大脑。JEV负责决策,Claude负责思考,Claude只在遇到难题时才被唤醒
下次开工前先收藏,然后阅读下面文章里完整的JEV + Claude拆解
AI 智能体与决策模型领域,现在值得关注的 15 个账号
过去几周,决策模型成了 X 上最主要的技术话题。下面这些账号用它们做过产品,或者给出过实测数据:
> @CompleteSkeptic - Diogo Almeida,TypeSafe 的 CEO,Jev 背后的人
> @swyx - 采访过 Jev 的创始人,持续追踪整个生态的走向
> @hwchase17 - LangChain 创始人,关注工具路由和智能体循环,称浏览器操作是他见过的最好的 Jev 应用
> @ndrezn - 用 LangChain 和 Jev 跑过浏览器操作
> @levie - Box 的 CEO,演示了 Jev 把事故报告分流到不同的升级路径
> @cline - 发布了一个给 Jev 接入浏览器的插件
> @browser_use - 发布了 jev-ultrafast,一个基于 Jev 的浏览器智能体
> @trycua - 开源了 CUA-S1-FORMS,一个小型 System One 电脑操作模型
> @mitsuhiko - Armin Ronacher,指出模型路由是 Jev 的一个用途
> @simonw - Simon Willison,真实的提示词、真实的失败案例、工具拆解
> @altryne - Alex Volkov,主持 ThursdAI 每周回顾,演示过一个实时 X 时间线分类器
> @jeremyphoward - 小模型效率与开放科学思路
> @HamelHusain - 上线前的评估与度
> @ValsAI - 前沿模型的基准测试数据
> @karpathy - 模型是如何工作的
这只开源机器人螃蟹有点离谱:22 个自由度,能跳、能抓东西,甚至还能拿着抹布擦地。
KingKongRobotics 做的 Jumper 最近让我反复看了好几遍视频。它的动作相当灵活,几条机械腿可以协调完成跳跃、转向和抓取,甚至还能跳舞。
更有意思的是,他们把项目开源了。
GitHub 上已经有源代码、组装教程和不同外观的模型,还提供了用于实验和开发动作的 AI toolkit。你可以研究它的机械结构,修改动作,尝试给它增加新的能力。
我特别喜欢这种 Physical AI 项目,因为机器人真的会把代码里的东西变成肉眼可见的动作。
如果继续给 Jumper 接入 computer vision、AI agents 和 local models,它能玩的东西还会多得多。比如识别房间里的物品、根据周围环境规划路线,或者通过 reinforcement learning 学习新的动作。
我甚至想给它搭一套这样的 AI stack:
> multimodal AI - 识别周围环境
> AI agents - 理解任务和规划动作
> local inference - 在设备上快速做出判断
> small models - 处理简单决策
> motion policy - 控制机械腿
> simulation - 训练和测试新动作
最近 AI 圈一直在讨论 GPT-6.1 Sol、Claude Haiku 5.5、open-weight models 和越来越便宜的 inference。@GoogleDeepMind 和 @nvidia 也在持续推进 embodied AI、robotics 和机器人训练技术。
这些技术让我对 Jumper 这样的开源项目更感兴趣了。
它已经有相当不错的机械运动能力。如果再把视觉感知、任务规划和本地推理逐步整合进去,开发者就可以围绕同一个机器人尝试很多不同的应用。
而且 22 个自由度本身就给了它很大的发挥空间。看它用几条机械腿灵活移动,再伸出夹爪去抓东西,真的很难不想自己组装一台。
我已经开始期待社区会把它改造成什么样了。尤其是现在 Physical AI、embodied AI、on-device AI 和 open-source robotics 都在快速发展。
视频值得看完,特别是它移动和抓取物体的部分。
GitHub 的源代码和组装教程我会放在下面。喜欢 robotics、AI agents 或者自己动手做硬件的,可以收藏这个项目。
一位独立开发者搭了一套 CLAUDE CODE TEAM,开始靠这套系统的产出赚钱,后来他发现:整套系统里最有价值的模型,甚至根本不写代码。
我是在研究大家现在怎么把 coding agents 用到真实工作里时,偶然看到这套 setup 的。不是为了做一个好看的 demo,而是真的把多个模型放进同一个工作流里。
他把 Opus 5.5 留作 lead architect。Sonnet 5.5 在独立的 Git worktrees 里并行工作,负责主要开发,一个做 frontend,一个做 backend。
整支团队里最特别的是 Fable 5.1。
它是 read-only,不写代码,也不负责修 bug,更不会催着团队赶紧完成任务。它只做一件事:盯着其他 agent 的结果,找出大家是不是太早觉得“已经做完了”。
有一次运行里,backend 连续两次栽在同一个问题上。
Fable 没让它继续普通的 patch -> retry,而是逼着整个团队回去看 root cause。之后 Sonnet 修好了 migration,两个 worktree 重新对齐,最后结果才回到 Opus 那里 merge。
而整个系统下面还有一层 Jev。
它负责 workflow 里那些很小的 decision:which file、which tool、retry or stop。简单分支根本不会送到昂贵的 reasoning model。
> Opus 5.5 - lead architect
> Sonnet 5.5 - parallel worktrees
> Fable 5.1 - adversary
> Jev - routing + fast decisions
> Claude Code Agent Teams - orchestration
我只是作为研究者偶然发现了这套系统,但现在这种案例对我来说,比大多数新的 benchmark 有意思得多。
这个人能靠它赚钱,并不是因为他找到了“最聪明的模型”。
而是因为他搭出了一支真正分工的团队:强模型负责思考,工作模型负责执行,另一个 agent 专门和它们唱反调,而那些很小的判断,甚至根本不会走到昂贵的 reasoning。
我后来把这件事继续往下拆,写成了一篇文章。
看完这个视频再去读,会更容易理解为什么真正值得优化的,很多时候并不是模型本身,而是模型到底在什么时候才应该被叫进来。
如果你也在做 Claude Code、Agent Teams、multi-agent workflows 或 model routing,可以先把这条存下来。文章放在下面。
我做了一个 PROMPT CRAWLER,它会先判断,到底什么内容值得进入 CONTEXT WINDOW。
我现在越做 AI agents,就越觉得传统的 prompt engineering 有点奇怪:先堆一个巨大的 system prompt,整段丢给 LLM,然后希望模型自己判断这次到底哪些内容真的重要。
所以我想把它当成一个 context engineering 问题来处理。
这个 crawler 会把 system prompt 拆成一张图。role、objective、context、rules、review 这些部分不再只是一个大段文本。它会沿着这些部分之间的关系往下走,找依赖、标记模糊的地方,也会告诉你哪些部分其实真的彼此相关。
这次运行的数据是:
> 181/181 words read
> 45 links found
> 12 places flagged
> 0 guessed
> spec score: 82
但真正有意思的是 traversal 里面发生的事。
我把 Jev 放进了这里。
每走到一个新的分支,它不需要生成一大段文字。它只需要做一个 decision:继续往下、停下来、换一条分支,还是把某一块交给更大的 reasoning model。
本质上,这就是在真正发生 LLM call 之前先做一次 LLM routing。
而我越看这个结果,越觉得现在 AI agents 的瓶颈已经不只是模型能力了。
问题越来越变成:我们到底有没有判断好,什么 context 应该进入模型。
更大的 context window 并不会自动修好差的架构。
它只是让你有能力把更多没必要的东西一起塞进去。
视频里可以直接看到 crawler 怎么沿着 prompt 一路往下走,最后慢慢拼出一张真正有意义的结构图。
对我来说,这也是现在从 prompt engineering 往 context engineering 迁移里最有意思的地方。
有时候,想让大模型回答得更好,最有效的方法不是再给它更多内容。
而是先别把那些它根本不需要看的东西发给它。
我做了一个 WEB CRAWLER,它会尽量避免在没有必要的时候调用大模型。
视频里可以看到,这个 bot 会沿着网站不断爬取,打开新的分支,然后逐渐缩小搜索范围。对我来说,真正有意思的并不是 crawler 本身,而是每一步之间发生的事情。我把 Jev 放进了处理这些小决策的那一层,这样就不用把每一次新的跳转、每一条链接、每一个不确定的判断都直接交给 Claude。
最后形成的逻辑其实很简单:web crawler 在网络里不断移动,Jev 帮它判断接下来到底值不值得继续往某个方向走,而大模型只会在真正需要完整上下文和 reasoning 的地方介入。短距离搜索时,这种区别几乎感觉不到。但当 crawler 开始执行几百次跳转以后,你就会很清楚地看到,把强大的 LLM 当成一个通用 if 来使用到底有多贵。
也正是做完这种实验以后,我开始用不同的方式看 AI stack。有时候,系统真正的改进并不是再加一个新模型,而是把原来的模型从那些你自己曾经随手塞进去的位置里拿掉一半。
我在文章里把这个思路讲得更详细。先看视频,再去读那篇文章,你会更容易理解为什么这种中间层是有意义的。
如果你也在做 Agent 或 web crawler,可以先把这条存下来。如果你的 pipeline 现在每走两步就要调用一次 Claude,那就把这条发给设计这个 pipeline 的人。
网页爬虫有一个很多 AI Agent 都没有的优点:它不会每走一步都去调用 Claude。
看 crawler 的动画,其实很容易看出,大部分 Agent 工作真实是什么样子。系统沿着网络不断移动,有些东西直接丢掉,有些地方会停一下,有些地方继续往下走。表面上看起来是一个很复杂的过程,但内部其实充满了大量很小的判断,而这些判断本身几乎不值多少钱。
问题出现在我们拿这样的系统,加上 AI,然后开始默认几乎每一次犹豫都值得调用一次完整的 LLM。于是 Agent 连那些只需要一个简单选择的地方,也开始为“智能”付费。一步看不出来,走到第一千步的时候,就完全不一样了。
这也是为什么 Jev 对我来说有意思的地方,不是它是不是又一个可以塞进 stack 里的模型,而是它试图把一点常识重新带回系统架构里。大模型应该只在真的离不开它的时候出现。其他步骤没有必要仅仅因为我们有能力调用 expensive reasoning,就都变成 expensive reasoning。
从这个角度看,网页爬虫其实是一个很好的视觉比喻:它可以走非常远,但不会把每一步都变成一次“智能事件”。
而且这种系统看得越多,“哪个模型更强”这个问题就越不重要。更重要的是另一个问题:
你到底有多少次,其实根本不应该调用模型?
这也是我那篇文章真正想讲的:
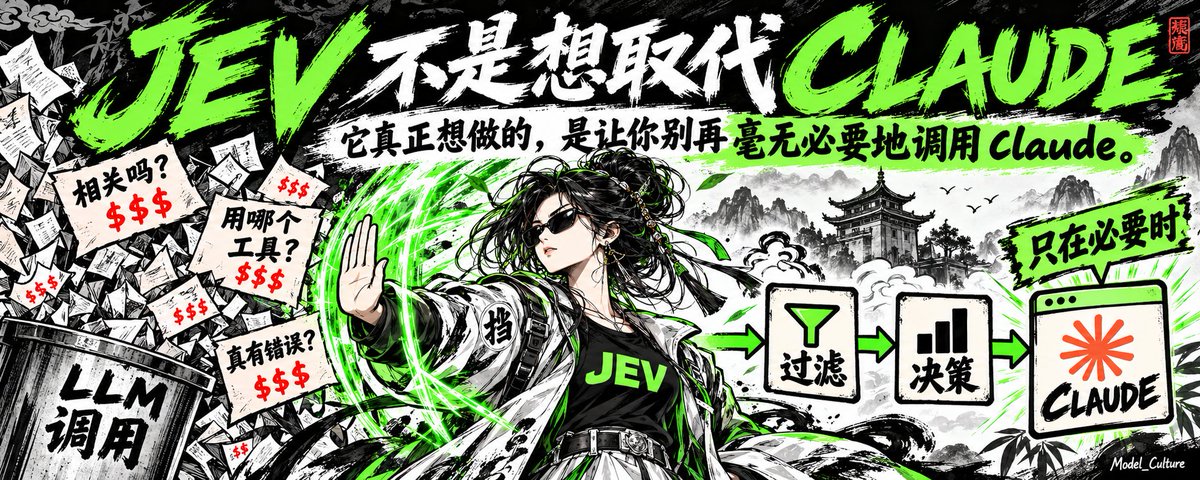
JEV 并不是想取代 Claude。它真正想做的,是让你别再毫无必要地调用 Claude。
AI真正先淘汰的,可能不是工作,而是“成为资深员工之前的那几年”。
很多人还在争论“AI会不会抢走工作”,但这个问题可能已经问错了。现在更值得注意的是,公司并不一定需要大规模裁员,它只需要停止招聘那些原本用来培养未来资深员工的人。Stanford最近关于AI与劳动力需求的研究已经看到类似趋势:受生成式AI影响更大的公司,对初级岗位的需求下降,而更资深岗位的需求反而在增加。结果可能不是“所有人都失业”,而是职业阶梯最下面的几级开始消失。一个行业完全可以继续增长,同时让刚毕业的人越来越难进去。
更麻烦的是,留下来的人正在变得越来越“宽”。一个销售可以自己做营销材料,一个工程师可以处理部分产品和数据工作,一个创始人带着几个Agent就能完成过去需要一个小团队才能完成的事情。企业过去依赖明确的部门边界,因为跨部门协作很慢、很贵。AI把这部分摩擦压低之后,公司真正需要的人可能会越来越少,但每个人负责的范围会越来越大。于是最值钱的员工不再只是“某一项技能做得很好”,而是能同时理解技术、业务、客户、产品,然后把一堆模型和Agent组织起来,把结果交出来。
这也让“未来的Senior从哪里来”变成了一个很尴尬的问题。过去的Senior几乎都做过Junior。他们写过简单代码,做过基础分析,被review过,犯过低级错误,慢慢学会承担更复杂的责任。但AI最先拿走的,恰恰可能就是这些最适合用来学习的工作。如果公司以后只想要一进门就能独立负责一大块业务的人,那么下一代Senior也许根本不是在传统公司里被培养出来的。他们可能来自那些自己做产品、找客户、卖项目、融资、管理Agent,甚至连续失败几次之后还继续做东西的人。
所以我越来越觉得,“AI会不会取代工作”只是表面问题。真正危险的变化是,公司可能还在招人,工作也还存在,但它们越来越不愿意为一个人支付学习成本。你要么已经能够独立创造结果,要么连进入系统的机会都越来越少。
简立峰这场台大演讲《AI時代:機會與挑戰》很适合放在这个问题旁边看。它不是在替上面的判断背书,也不是这篇帖子的“证据”,但看完之后再回来想一遍职业、教育和AI之间的关系,会更有意思。
我这两天一直在看中文圈是怎么用 Jev 的,已经比单纯讨论“新模型更快、更便宜”有意思多了。大家开始认真测试它到底适合放进哪些 workflow,哪些地方会失效,哪些任务还是应该交给普通 LLM,以及哪些场景里调用 Claude 本身就已经变成了一种昂贵的习惯。
看了几个这样的实测之后,“Jev 能不能取代 Claude”这个问题反而显得有点无聊。Jev 本来就不是在做这件事。如果系统在某一步真正需要的只是一个选择、一个概率,或者一个简单判断,为什么每次都要把完整上下文塞进一个大型生成模型,再让它跑一遍 reasoning?
我刚好专门写了一篇文章讲这个问题:
JEV 并不是想取代 Claude。它真正想做的,是让你别再毫无必要地调用 Claude。
下面我会放几条中文视频。有基础介绍,也有比较实际的测试,还有一些专门在摸 Jev 能力边界的内容。看完两三个之后,你很可能会开始重新看自己的 AI stack。
如果你想自己看看中文作者已经怎么测试 Jev,可以先从下面这些视频开始。
Jev 实测: 这款爆火的极速决策模型的基本玩法 - 01Coder
youtube.com/watch?v=tYvu6IpS…
7分钟解读Jev模型; 成本低速度快专为决策场景而生 - 晓辉博士
youtube.com/watch?v=xD41x2ml…
Jev判定模型是什么: 价格, 能力边界与使用方法? - 老范讲故事
youtube.com/watch?v=9ciho6DD…
爆火的 TypeSafe AI Jev 模型到底怎么玩? 海量社区案例带你入门, 附两个实战 Demo - NiceKate AI
youtube.com/watch?v=FQFKZiDO…
超火大模型Jev, 保姆级介绍和使用教程 - AI随风
youtube.com/watch?v=GJJq4LXH…
我不会把它们当成“又五个模型评测”来看。更值得注意的是,这些作者在哪些步骤里开始觉得大模型根本没必要出现。Jev 真正有意思的地方,往往就在这里。
