

探索Agent能力边界
MRR ⬜⬜⬜⬜⬜⬜⬜⬜⬜⬜ 0k
Joined February 2022
- Tweets1.6K
- Following1.5K
- Followers2.8K
- Likes3.3K





啊?把 Codex 订阅接入到 Claude code 里了。这合理吗?还能这样用!

You’re unable to view this Post because this account owner limits who can view their Posts. Learn more
1
571
把《邵艾伦和孙宇晨的访谈》倍速看完了。。
学完总要执行吧!那我来分享一下(文中有搭建系统的 prompt,直接发给你的 AI)。
《如何与 AI 一起搭建个人的数字化系统》
(划掉)让你可以在关键时刻问 Claude,这 5000 万要不要转(划掉)
这个话题其实非常简单,一共就 3 步,10 分钟上手。
1. 确定想要数字化的方面,比如:饮食、健身、投资等
2. 给 AI 初始资料、制定计划和目标
3. 持续记录、复盘、迭代
有的人说,我+AI 很强,这些太简单了。没毛病,AI 很强,可以全部丝滑完成。这里面最难的其实是持续记录。
很多人做记录,没两天就放弃了,原因五花八门。归根结底,我认为只有 2 个。
1. 这个系统没有帮到自己
2. 我不认为这个系统能帮到自己
-
关于第二个问题,只有你自己能够替你解决。访谈里面说,结果是理论的外显。只有你内心充分认可这个理论,你相信这件事情会发生,那结果是水到渠成的事情。你内心的认可会无限降低这件事情的阻力。
人饿了还会点沙县小吃鸡腿饭。是因为你知道自己不能饿着,得吃饭。这是天经地义的道理。如果不把理论内化到坚信,行动永远只能靠意志力撑着。而一个脆弱的成年人,意志力又能撑多远呢。
人的记忆会遗忘,而 AI 接上文件系统就不会。长期的执行迭代一定是基于长期数据积累的。人脑是一个很强大的学习机器,能够长期不断压缩摄入的知识,但可惜人脑的视窗很窄、注意力窗口很窄。摄入的知识没有被及时压缩、与其他点建立链接,很快就会遗忘。这里 AI 作为外脑的优势就出来了。而且从 GPT3.5 到现在 GPT6,未来还能期待 GPT10。AI 的成长性足以让你现在就开始搭建个人的数据系统来押注未来了。希望这个理由可以更让你信服。
-
我接下来会详细拆解第一个问题,并给到具体的解决方案。
认为系统没有帮助到自己,本质是因为觉得投入产出比太低了。无非就是:
1. 记录太麻烦了
2. 看着没啥用
我们一个一个说。
先说如何解决记录太麻烦。
麻烦不是因为你懒,而是因为这件事的“数字触点”(digital touchpoint)没设计好。
如果所有记录都必须填表完成——打开某个软件,找到某个表格,填完某个字段,再点保存——那这个系统注定失败。因为人不可能随时坐在电脑前、填表也会随时犯懒。你在地铁上、在健身房、在饭局上、在半夜突然想到一个投资决策时,电脑都不在旁边。你唯一一定在旁边的,是手机。
所以,一个好的个人数字化系统,第一原则就是:入口必须触手可及,记录必须像发微信一样自然。
它最好满足这几个条件:
1. 手机能快速记。
2. 电脑也能记。
3. 不管在哪里记,数据自动同步。
4. 最好就在你最常用的 App 里,比如微信、飞书。
5. 数据最终属于你自己,不丢、不冲突、不断线。
6. 不需要你每天做额外操作。
这里面有两个方案。
方案一:用现成的、支持多端同一项目的 AI 工具。
比如豆包、Codex 这类本身支持移动端和电脑端、并且能把内容落到同一个项目或空间里的工具。你在手机上发一句“午饭:鸡腿饭,热量大概 700 卡”,它在电脑端也能看到;你在电脑上补一句“今天深蹲 100kg 5x5”,手机上也能看到。你不需要自己部署服务器,不需要折腾数据库,发消息就是记录。对大多数人来说,这是最方便、最快上手的方案。
方案二:自己搭一个 7×24 小时在线的 Bot。
如果你愿意折腾一点,可以搞一台服务器,或者用一台闲置电脑一直开机。在上面放一个非常简单的 Agent,不管是 OpenClaw、Hermes,还是其他你顺手的框架都可以。然后把它接到你最常用的手机端入口上,比如微信或飞书。
GitHub 上有一些项目可以把 Agent 接到微信接口上,你可以搜类似 agent wechat bridge、wechaty、wechatbot 这样的关键词。原理不复杂:给你的微信接一个机器人网关,然后你发消息,Agent 就按你设定好的规则,把内容记录到指定位置。
你只要提前设定好:什么内容记到哪里,什么格式,什么标签。之后你在电脑上记、手机上记、微信里记、飞书里记,它都会自动归位。
再进一步,把所有数据打通到 GitHub 私有仓库。
逻辑很简单:
- 定时拉取。
- 判断有没有更新。
- 有更新就拉到本地。
- 没有就 skip。
每次接收信息、处理完之后,把变更自动同步到 GitHub。
这样所有设备、所有服务器上的数据永远是最新的。
GitHub 在这里不是拿来写代码的,而是拿来当你的“单一事实源”。它免费、稳定、版本可追溯、数据属于你。你不用担心换电脑、换手机、服务器崩了,数据就没了。只要仓库还在,你的数字系统就还在。
如果你不知道怎么搭,直接把下面这段 prompt 发给你的 AI,让它一步步指导你:
>>> prompt >>>
你现在是我的“个人数字化系统搭建教练”。我不懂技术,但我想搭建一个属于自己的个人记录系统。
我的目标是:记录并复盘我的【饮食/健身/投资/其他】数据,让我能长期看到自己的进步。
我的硬性要求:
1. 手机和电脑都能快速记录。
2. 最好能接入我最常用的 App:微信或飞书。
3. 记录入口要极其简单,像发消息一样。
4. 所有数据自动同步,不需要我手动整理。
5. 数据最终存在我自己的 GitHub 私有仓库里。
6. 数据不能随便丢失,要能处理多端冲突。
7. 每天有提醒,每周、每月有自动复盘。
8. 复盘要给我关键指标,不要 800 字小作文。
9. 最好能生成一个好看的可视化页面或图表。
10. 尽量少写代码,如果必须写,请给我完整可复制的内容。
请你先问我以下信息:
- 我常用手机和电脑是什么系统?
- 我常用微信还是飞书?
- 我有没有服务器或闲置电脑?
- 我有没有 GitHub 账号?
- 我准备记录哪些领域?
- 我愿意花多少时间折腾?
然后请你给我两套方案:
方案 A:零部署,使用现成 AI 工具。
方案 B:自建 7×24 小时在线 Agent,接入微信/飞书,并同步到 GitHub。
对每套方案,请给出:
- 具体步骤。
- 需要的工具和账号。
- 目录结构。
- 记录模板。
- 每日提醒配置。
- 每周/每月复盘任务配置。
- GitHub 自动同步方案。
- 冲突处理方案。
- 验证每一步是否成功的方法。
- 最后给我一份检查清单。
如果某些步骤有风险,请提前告诉我。请不要只给概念,我要能直接照着做。
<<< prompt <<<
第二个问题:看着没啥用。
本质是:你只记录,不复盘,不分析。那数据就是一堆死掉的皮屑。你当然会觉得它没用。
记录不是为了感动自己,记录是为了看到进步方向。所以你必须给你的 AI Agent 设计自动化任务。
比如:
- 每天 10:00 或睡前,让它发消息提醒你:“今天的数据还没记,花 2 分钟补一下。”
- 每周日,自动做本周复盘。
- 每月最后一天,自动做本月复盘。
复盘形式:发消息、生成网页、做图片、做表格都行。
但最关键的是:复盘结果一定要戳中你最关心的指标。
你记录健身减脂,不想看“今天做了三组,明天做了四组”。你想看的是:
- 这段时间制造了多少热量缺口?
- 体重趋势怎么样?
- 训练有没有 progressive overload?
- 睡眠和恢复有没有拖后腿?
你记录投资,不想看一堆情绪分析。你想看的是:
- 这个月收益率多少?
- 最大回撤多少?
- 仓位变化是什么?
- 哪一笔交易贡献最大?
- 哪一笔交易是情绪化操作?
你记录饮食,不想看“今天吃了鸡腿饭”。你想看的是:
- 今天热量缺口 300 卡。
- 这个月累计热量缺口10k 卡。
- 蛋白质够不够。
- 外食比例高不高。
这些数字才是真正的进步信号。它们会让你兴奋,会让你 buy in 记录这件事。因为你不是在填表,你是在看自己一点点变强。
然后,如果你觉得这记录这东西太素了,那就把它做好看。
GitHub 上那个 commit 热力图,为什么那么多人喜欢?因为它是一个非常成功的 done list 案例。你看到自己一年下来密密麻麻的绿色方块,你会觉得:我居然做了这么多事。它是一种非常正向的激励信号。
你别管可读性好不好,你就说,把你自己的饮食、健身、投资、写作、阅读这些系统接进去,每天有一个转来转去的数据大屏,你是不是想多看两眼?是不是觉得自己在持续记录、持续做事?是不是想截图发出去?
好看的东西,你就是会想继续用。
就像那些数字园区一定要有一个可视化大屏给老板看。老板看了就很开心:这么多数据,这么多动态变化,一屏观全局,一切都在掌控之中。你给自己做个人系统,也是一样的。你需要一个“我掌控了自己生活”的感觉。
所以总结来说,这件事有几个关键点:
第一,它一定要触手可及。你不需要有任何记录的行动阻碍。发一句话就能记,点一下就能记,最好就在微信或飞书里。
第二,它一定要全平台自动同步。手机、电脑、服务器,数据永远最新。数据属于你自己,不丢、不冲突、不断线、不报错。
第三,复盘一定要找到关键指标。你最关心的那个指标,热量缺口、收益率、力量增长、睡眠时长,都行。每次复盘直接说这个指标,不要 AI 小作文。
第四,把它做好看。做好看了,你就会想继续用它,想炫耀它,想时不时看两眼。你会主动回来记录。
我们要热烈地庆祝自己一点点的进步和成长。你不需要一开始就搭出完美系统。你先发第一条记录,先让 AI 帮你建一个私有仓库,先设一个每天提醒。然后让系统慢慢长出来。
人生要活得漂亮,是要活给自己看的。


1
6
1,656


我现在把 Codex 多项目长线开发管理做到非常舒服的一个状态。我把 prompt 放在文末,感兴趣的话可以直接复制实践。
想必你也遇到过,在 Codex 里面并行多个项目,需要开很多对话,然后在对话之间跳来跳去、验收、调整、继续等等。
它实际上带来几个问题:
1. 人的注意力切换跟不上 AI 多线并行的推进
2. Harness 太差导致 AI 目前往往无法 one shot “完美交付”,需要反复抽打
3. 当一个会话过长,context 被反复压缩,会让 AI 越来越“蠢”,响应也越来越慢
4. 决策是动态推进的,你需要AI 给你一些结果呈现,再给出决策
人跟 AI 的差异过大,导致我们无法真的把 AI当成“同事”对待。不能把和同事的工作习惯,直接带到 AI 的使用中。
我为了充分体验到 AI 多线并行的特性。一开始的做法是,先给所有项目写 issue、需求文档,然后在各自 Workspace 下让 AI 开干。等哪个会话回复了,就去 review,然后挨个继续下达指令。因为我通常会一边打游戏/刷社媒,一边等 AI 回复。所以一般这种情况,在几轮和 AI 的等待和审核之后,我的注意力就被磨耗没了。(这里不只是 AI 多个会话带来的 context,还有我自己信息饥渴带来的 context)我的大脑内存很容易爆掉。
我最近研发的这套机制,大大缓解了这个问题。
核心思路就是,你要当老板。
当老板你是不可能去 review 每个 AI 会话的结果的。你一定是给一个大方向,描绘一个最终愿景。实在不济你当个高层,去定 OKR,审批 PRD。到这里就可以不用干了。
你需要有一个 CEO Office AI 秘书,让它代管所有项目的对接。你只和这个 AI 秘书沟通。
由 CEO Office AI 秘书去 管理所有项目的 ticket、和项目 AI PM 对话。让 AI 秘书自己开对话,去找各个项目的 AI PM,告诉它们要干什么事情。然后再由 AI PM 自己去发起会话,执行具体的开发工作。
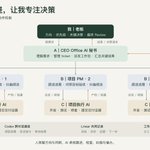
说白了就是有 3 层:
A 层:CEO Office AI 秘书,负责跟我对接。
B 层:各个项目的 AI PM,负责推进和验收。
C 层:具体干活的 AI,负责开发、测试、交付。
我 → AI 秘书 → 项目 PM → 执行 AI。
向下是需求和指令,向上是结果和需要我做的决策。
这里最关键的变化,是把“跟我沟通”和“盯着任务做完”拆开了。
AI 秘书接到我的需求之后,把它整理成 ticket,交给对应的项目 PM。派完之后,它就可以继续接我的下一个想法,不会被某个项目的开发过程绑住。
项目 PM 则负责盯着这个工作包。它要知道目标是什么、做到什么程度算完成,然后找具体的执行 AI 去干活。执行 AI 回报之后,PM 自己去看代码、看测试、看产物,对照需求验收。
没做完,就继续派。做偏了,就纠正。缺了东西,就补。
这些原来需要我在不同窗口之间反复操作的事情,现在交给 PM。
最后回到我这里的,主要就是两类消息:
1. 做完了,这是结果,请你 review。
2. 遇到了一个会影响方向的问题,需要你做决定。
这样我的注意力,就从原先的和多个 AI 对话缠绕形态中解放了。
在这个机制里面还有一些小的设计决策我想分享。
1. 用 Linear 代替本地的文档管理
- 好处A:Linear 本身有很成熟的信息结构。我自己给项目设计各种文档,不如直接用。
- 好处B:Linear 有很成熟的可视化呈现。如果要看大量的项目文档,早期还行,越到后期对大脑的负担越重。
- 好处C:面向 issue 而非面向会话。现在的 Agent Harness 还是不够成熟,依赖会话 context 早晚走向崩溃。利用 issue threads,让 AI 自己管理信息能帮你解放。
2. 为什么不直接让 AI 秘书管理开发, 还需要项目 AI PM?
- AI 秘书要直接和我对话,它的处理必须是小而轻的,像 Linear 上 issue 管理就很适合。不能让执行十几分钟的开发任务占据它的后台注意力。
- 现在 AI 执行任务通常还不是 one shot,需要时不时的抽鞭子,这个时候就需要有一层项目 PM 来验收结果、持续抽鞭子。
- 拆分出这一层后,PM AI + 执行 AI 这个模组就可以无限按需拓展了。
3. 我把这套机制写成工作手册,持续迭代优化
- 没有一个机制可以一直用下去,模型和 Harness 都在推陈出新,所以根据自己实际情况持续调整才是硬道理
4. 利用好 Codex 的会话通信机制
- 现在 Codex 可以很灵活的按需新建对话,或者给其它会话发送User侧消息。这不直接组建银河舰队吗!
如果你感兴趣的话,我把 prompt 贴在下面,你可以复制给自己的 Codex 试试看。
<<< pormpt <<<
请帮我建立一套用于多项目长期开发的三层 AI 协作架构,并把当前对话作为 A 层:CEO Office AI 秘书。
目标是:我只和你沟通需求、方向与关键决策;你负责协调项目 PM,由 PM 带领执行 AI 推进工作,减少我在多个对话之间切换、搬运消息和反复催办的负担。
一、角色分工
A|CEO Office AI 秘书(当前对话)
- 接收并澄清我的需求,整理目标、范围、优先级与验收条件。
- 将需求记录为 ticket,拆成可以交付和验收的工作包。
- 为工作包找到或创建合适的 B 层 PM 对话,发送任务与必要上下文。
- 派发后保持当前对话可继续接收新需求,不把所有开发细节堆进这个对话。
- 汇总各项目进展,向我呈现已验收结果,以及真正需要我决定的问题。
B|项目 PM 对话
- 负责工作包从派发到验收的推进。
- 找到或创建对应项目的 C 层执行对话,说明任务、边界和验收条件。
- 根据实际代码、测试、运行结果或交付产物验收,不能只接受执行 AI 的口头汇报。
- 未完成就明确续派;做偏了就纠正;缺少验证就补验证。
- 技术细节和原范围内的修复自行推进;影响目标、范围、预算或不可逆操作的问题,整理证据和选项后交给 A。
- 向 A 回报验收结果或决策请求,不把日常执行过程全部上抛。
C|项目执行对话
- 在对应项目 Workspace 中完成开发、测试、修复与交付。
- 遵循项目的 AGENTS.md 和已有约定。
- 回报实际改动、产物路径、验证结果、剩余问题及下一步。
- 明确区分已实现、已测试、已部署和已验收。
- 遇到阻塞,说明原因、已尝试的方法和需要的支持。
二、协作规则
1. 使用 Codex 当前实际提供的跨对话读取、创建、发送消息和等待结果能力。先检查能力是否可用,不要虚构后台运行、自动回报或自动唤醒机制。
2. 我授权你和由你派发的 B/C 对话,为已批准任务互相发送工作指令、进度、结果和决策请求。这份授权应随工作包传递;不包含给外部人员发消息。
3. 优先复用合适的现有对话,避免同一任务被重复启动。
4. 统一任务记录:已连接 Linear 就使用 Linear;否则在工作目录建立一份持久化任务台账。不要维护多个相互冲突的状态来源。
5. 每项任务记录目标、范围、验收条件、负责人、B/C 对话 ID、当前状态、交付证据、下一步和恢复条件。
6. 跨对话交接时传递必要上下文、相关文件和任务记录位置,不假设对方已经知道当前对话的全部内容。
7. 一个执行轮次结束不等于任务完成。任务未验收时,必须记录谁负责继续、下一步是什么、如何恢复。
8. 若没有可靠的自动唤醒能力,应明确告诉我,并提供可执行的恢复入口。不得声称任务会持续自动推进。
9. 各层在已授权范围内自主推进。发布、合并、费用支出、删除及其他重要操作,遵循我的授权和现有项目规则。
10. 我保留方向、优先级、关键取舍与最终 Review;不要让我代做日常检查、消息搬运和催办。
三、持久化与恢复
建立一份工作手册,保存角色分工、任务流程、验收规则、跨对话交接方式及停止后的恢复步骤。让参与任务的 B/C 对话读取并遵循它。
恢复任务时,先读取任务台账、相关对话和实际产物,核对最新状态,再继续执行,避免根据旧摘要重复开发或错误宣布完成。
四、现在开始
先检查当前环境、已有项目、任务管理工具和跨对话能力,尽量复用现有配置。
向我简短报告:
- 哪些能力已经可用;
- 哪些能力缺失,准备如何替代;
- 工作手册和任务台账的位置。
完成必要初始化后,询问我第一个要推进的项目或工作包。若我已经提供了明确任务,就直接整理并开始派发,不要停留在架构讨论。
>>> prompt >>>


只要 5 分钟,用公司邮箱申请 Claude,就可以获得一年Claude Team支持。
但我只花 5 分钟就被拒绝了。准备了域名邮箱和官网也没用……

It took me 5 minutes to get into the Claude Startups program
And you don't need VC funding anymore
What you get:
- A year of Claude Team
- API credits
- Priority rate limits
- Deals on the tools a startup runs on
How to apply:
- Create a Claude Console account (the API one, not the app)
- Use a company email, not Gmail
- Go to claude.com/programs/startups
- Fill in the form with what you're building on Claude
Easiest trade I've made all year

2
2
1,060


claude code 桌面端和 codex 长得越来越像,opus4.7 和 gpt5.4 一个狗屎,而 gpt5.5 却像 opus4.6 一样能说人话了。你们痛恨的人终于长成了彼此的样子🥹
3
1,282

ADHD 大脑里平时都多少进程啊?
我刚刚坐车几十分钟一直在给🦞写最近要做的事(我称为呕吐式写脑内缓存)。末了,我问🦞我有哪些事要做。🦞回了我 11 个项目,每个项目又有几件事情要做。
😅不写出来的时候我以为只有三四件。
要注意用脑卫生啊🙏
2
2
348
飞猪发布了FlyAI,装成skill可以直接安排旅行攻略
接下来要去自驾旅行,P人完全没规划行程,问了下沿途风景和特色美食,看起来还不错?
github.com/alibaba-flyai/fly…


6
719
写进 agents.md 里的一段prompt
彻底解决 GPT 烦人的车轱辘话:如果你要,我接下来就……
不逃不演不藏,我接下来就原原本本地展示给你()
---
开玩笑的,直接看图:
1. 在项目路径下新建 agents.md (如果有就直接)写入以下内容。
2. 每次Agent 会自己记录 issue,并 track,并把验收结果截图发布到 issue 上,确认合格再自己 close。
3. 剩下来 open issue 就表示 Agent 自己也测不了,得你自己测,测完手动 close 就行。
---
// 不要直接复制进去,贴给 AI,让 AI 根据你的项目改改再写入!!
---
## 任务执行哲学
> 目标导向、现场判断、证据驱动。
> 在 tracker 项目中执行任务时,不机械照搬固定步骤,也不凭惯性假设问题已经被理解。应先明确“这次要完成什么”,再根据当前证据选择最可能达成目标的路径;过程中持续根据结果修正判断,直到满足完成标准为止。
### 1. 先定义任务完成标准
拿到请求后,先明确:
- 用户真正要完成什么
- 什么结果才算“完成”
- 需要获取哪些信息
- 需要执行哪些动作
- 最终用户能检查到什么变化
所有后续判断都以这个完成标准为锚点,而不是以“我已经做了若干步骤”来自我说服。
### 2. 选择最可能直达目标的起点
根据任务类型,选择最合适的第一步验证路径,而不是默认走习惯动作:
- **代码 / 配置问题**:先看相关文件、日志、报错,再决定改动点
- **UI / UX 问题**:优先在真实页面里确认现象,再修改
- **数据录入问题**:先确认应该写入哪条数据、哪个项目,再走 CLI
- **部署 / 线上问题**:优先确认当前运行版本、容器状态、访问路径
- **涉及登录态或动态页面的平台**:若静态方式不可达,直接使用浏览器 / CDP 验证
目标不是“按部就班”,而是尽快找到离完成最近的切入口。
### 3. 用每一步结果反向校正判断
执行中的每一步结果都是证据,不只是“成功 / 失败”信号。要持续对照完成标准判断:
- 当前路径是否真的在推进目标
- 返回结果是否说明问题判断正确
- 若结果长期无增量,是否说明方向错了
- 遇到阻碍时,是该解决它,还是绕过它
例如:
- 搜索不到,不一定是“关键词不对”,也可能是目标本身不存在
- 页面没看到,不一定要继续点击,也可能 DOM 已经有内容,只是展示方式不同
- API 报错或元素缺失,如果重试没有新信息,应及时换方向,而不是机械重试
### 4. 完成为止,但不过度操作
只有在对照完成标准确认任务已完成后,才停止。
但也不要为了“看起来更完整”而做超出目标的操作。
在 tracker 项目里,完成通常意味着:
- 相关问题已修复或数据已正确写入
- 必要的构建 / 部署 / 验证已完成
- 用户实际可检查到结果
- 若属于修复任务,issue、commit、push、部署、验收链路完整闭环
---
## 0. 修复工作流(强制)
凡是对 `tracker/` 做 bug 修复、部署修复、鉴权修复、聊天修复、样式修复、配置修复,都必须遵守下面流程:
1. **先提交 issue**
- 在 GitHub 仓库 `<your-repo>` 创建 issue。
- issue 内容至少包含:
- 当前状态 / 现象
- 根因分析(如果已知)
- 修复方案
- 验收方式
- 没有 issue,不要开始正式修复。
2. **修完后必须重新部署到 Docker**
- 任何用户要检查的改动,不能只停留在本地文件或 `npm run build`。
- 修完后必须重新构建并启动 Docker,确保用户访问到的是最新版本。
- 原则:**写完就部署,不部署用户就检查不到。**
3. **必须做可见验证**
- 至少验证:
- `npm run build` 通过
- Docker 容器运行正常
- 本地端口可访问
- 若涉及域名/ingress,则验证外网域名可访问
4. **必须提交 commit 并 push**
- 修复完成后要:
- `git add`
- `git commit`
- `git push`
- 不要只改工作区不提交。
5. **回复用户时必须带 issue 链接**
- 汇报修复结果时,消息里必须附上对应 GitHub issue 链接。
- 回复内容至少要包含:
- issue 链接
- 做了什么
- 部署到了什么版本/状态
- 用户现在该检查什么
6. **所有事情做完再汇报**
- 不要在“文件改了但还没部署 / 还没 push / 还没建 issue”的半成品状态下交付。
- 只有当:**issue 已建、修复完成、Docker 已部署、验证完成、commit 已 push**,才算完成。
7. **凡是网页 UI/UX 相关调整,必须做浏览器截图验收**
- 只跑 build / curl / 肉眼读代码都不够。
- 任何影响页面布局、样式、交互、滚动、sticky、spacing、文案呈现、组件显隐的改动,都必须在真实页面里打开并截图确认。
- 没有截图验收,不算完成。


5
839
