

01,INFP 程序员在东莞,AI Native 专注 AI Coding · 独立开发 · Agent ✨ 我将分享: • AI Coding 技巧与 AI 前沿资讯 • 独立开发经验与踩坑总结 • Agent 应用与实践教程 🚀 2026,从 0 开始 探索 AI 浪潮下的无限可能
Joined June 2024
- Tweets6K
- Following453
- Followers5K
- Likes13.7K




继 Opus 5.5 加文字水印后,Anthropic 又把其他模型也加上文字水印了
11月3日起, Mythos 5、Opus 4.7、Opus 4.6、Sonnet 4.6,全部加上Opus 5.5 同款水印
只能说达里奥疯了,总觉得达里奥是不是有某种精神疾病🙂


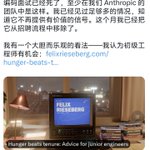
"Coding 面试已经死了,至少在 Anthropic 团队中是这样",anAnthropic 工程经理 Felix Rieseberg 表示道
他认为传统代码语言是越来越难以衡量工程师的能力,但是现在也没有更好的新范式
他目前的做法是,在简历和作品集中寻找小型模型,重点考察候选人在这些作品里体现出的产品品味、用户同理心,以及是否拥有清晰、成体系的思考方式
他同时认为,借助 AI,初级工程师有希望快速超越资深工程师,并给了一些建议:
1、优先业务影响力,而非 backlog
用 Patrick McKenzie 的话说,工程师是被雇来创造商业价值的,而不是写程序
工程师要先搞清楚公司/部门真正想达成的目标,找到合适的指标(了解你上级的上级在追求什么,也是很好的指标),把自己依附在赚钱或核心目标相关的部分
2、提出激进的想法
想几个一旦成功就能显著提升组织达成目标概率的点子。要有野心,不要只做小修小补
3、用一个周末把它做出来
Felix Rieseberg 已经看到个人或小团队通过直接做出可运行原型,这些原型的诞生跳过了写 PRD、争取 buy-in、协调设计师/PM 时间等传统流程
4、聚焦一个好想法
新人常犯的错误是把多个想法塞进一个原型,好点子被大量差点子淹没。所以不要试图同时做新语言 + 后端 + 移动端。原型的目的是清晰沟通机会,并让领导立刻明白这个想法值得做,而且你是能推进它的人
5、善用你的新鲜视角
用户产品:你对普通用户的同理心更强,更清楚产品真实使用体验
基础设施/工具:你还没接受那些“这不可能”的内部共识,很多“不可能”的限制只是很久没人重新验证
Felix Rieseberg 提到 Anthropic 内部例子,两位相对新的工程师(Anthony Morris 和 Alice Zhao)用一个周末做出 Claude Code 的图形界面原型,约 8 天后公开版本上线,并迅速成为很受欢迎的产品


The coding interview is dead, at least for my team at Anthropic. I've seen enough to know that it no longer provides signal. I removed it from loops this month.
I have a spicy, optimistic take - I think there's an opportunity for junior engineers: felixrieseberg.com/hunger-be…


AA 榜单最近更新挺频繁的啊,刚发布 Coding Agent Index v2.0 没多久,又发布了 Intelligence Index v5
测评标准变化:
1、新增 FrontierCode 2.0(编码类测,权重15%):Cognition推出的私有真实开源仓库编码任务(132个),评分标准是“仓库维护者是否会合并该改动”。任何阻塞性检查失败直接0分,任务保持私有
2、新增 Terminal-Bench-Science(科学类,权重15%):70个终端环境下的代理式科学研究任务,专家审核,全部测试通过才算通过
3、HLE 变更为 HLE-Diamond:精简为1000题版本(推理与知识各半),替换原Humanity's Last Exam
4、AA-Omniscience 变更为 v1.1:移除已饱和和公开题目,新增并修订模糊/错误题目;同时发布了公共子集用于对照
5、CritPt 变更为 v2 Hard Subset:取私有40题硬子集(从原70题中剔除前沿模型全部做对的题目),配合代码执行工具运行
其他值得注意的变化
1、任务整体更重:模型在每任务上的输出token中位数从约35k上升到59k,代理类任务占绝大部分token消耗
2、推理级别(effort)的影响更大:同一模型高低努力设置之间的分数差距扩大
3、同时推出了Progress Index v1,用于把2022年11月以来的模型放在同一连续尺度上追踪长期能力演进(与当前使用场景导向的Intelligence Index分开)
整体来看,v5更强调真实 Agent 工作流、私有数据防污染,以及四类能力更均衡的权重分配


Google DeepMind 发布 Genie 4,Google 称这是其迄今最逼真、最具交互性的世界模型
用户可以通过自然语言实时操控模拟世界及其音景,例如改变天气、移动摄像机或引入新元素。同时 Genie 4 还引入了环境音频和实时交互式人类对话
相比 Genie 3,Genie 4 场景时长翻倍(最长约 2 分钟)、空气动力学、碰撞等物理表现更真实、人物动作更自然;基于 Gemini Omni 增强真实感,并由 Gemini 模型负责推理与规划
Google 称,Genie 4 预计将在机器人/智能体安全训练环境、电影预可视化、游戏原型、教育等场景上发挥不错的表现
目前为研究预览版本,稍后向 Google AI Ultra 用户和开发者开放

Introducing Genie 4 from @GoogleDeepMind, our most realistic and interactive world model yet 🌍
Now you can use natural language to dynamically steer the world and its soundscape in real-time, whether you're changing the weather, moving the camera, or introducing new elements to the environment.
So, how does the model do that?
Behind the scenes, Gemini acts as the "brain" of the simulation. It translates your requests into actions, plans out complex events, watches the scene unfold to keep track of what's happening, and adjusts as you change the story. Genie 4 also introduces ambient audio and real-time interactive human dialogue that adapts on the fly.


OpenAI 发布 GPT-6.1 Terra,价格减半,性能直追旗舰。旨在以更低成本推动 AI Agent 在高频工作场景中的落地
Artificial Analysis 智能指数中,GPT-6.1 Terra(Max)得 48 分,低于 Kimi K3.1 Pro 的 55 分
在 Agents' Last Exam 中等推理强度下比上一代高 15 个百分点,单次任务成本降至约三分之一,并达到 GPT-6 Astra 水平
API 定价为输入每百万 Token 1 美元、缓存输入 0.05 美元、输出 5 美元,较 GPT-5.6 Terra 与 GPT-6.1 Sol 降低 50%
有网友实测 tps 惊人,实测约 450tps,最快可达 600 tps


Anthropic 正式提交纳斯达克IPO申请,或将成为史上最大 IPO
Anthropic 目前目标估值约在 1.5–2 万亿美元,募资规模可能超过 1000 亿美元
相比之下,2026 年 6 月上市的 SpaceX IPO 定价估值约 1.77 万亿美元,首日收盘市值约 2.1 万亿美元,募资约 750–860 亿美元
若 Anthropic 最终定价接近或超过 2 万亿美元,将直接超越 SpaceX,成为史上最大 IPO
起猛了,现在 AI 只动嘴就做出 3D 游戏了,这完成度也太高了吧

兄弟们,终于等到了!AI 做 3D 游戏终于进化到动嘴就能搞定了!!!
这妥妥的信息差啊!
以前做 3D 游戏,最卡独立开发者的从来不是写代码,而是美术和动作:建模、贴图、绑骨骼、刷蒙皮、找动捕或者一帧帧 K 动画……别说一个人了,一个小团队光调几个动作就能把人送走。
但我们最近用@ViggleAI的3D产品@Viggle_PINOC(用的是他们新发布的JST-2世界模型),直接搓了一款网页就能玩的 3D 小游戏《星芽旅行记》。
简单说,主角从长相到全身十几套动作,全靠打字搞定!而且成本便宜到不可思议。
我来给大家详细盘一下怎么玩的:
1、一张 2D 原画,直接变带骨骼的 3D 角色 给 PINOC 扔一张小园丁的 2D 设定图,它直接吐出一个带完整骨骼绑定的 3D 角色。4.8 万个高斯点,文件压出来只有 1.3MB!传统 3D 里最磨人的建模、拓扑、贴图、手动绑骨蒙皮,这一步直接全省了。
2、动作全靠一句话描述,导出直接用 这个最神!想要什么动作直接打字,比如写一句"手脚并用顺着粗藤往上爬,双臂交替上伸",很快就拿到一段 4 秒的标准骨骼动画,导出 GLB 直接塞进游戏。 走跑跳、旋转攻击、滑铲钻横杆、前后空翻、下砸、飞扑、爬藤、滑翔、跪地播种……十几套动作,大部分都是一句话生成的,剩下几段直接从 PINOC 自带的免费动作库里挑。 更绝的是它底层共用一套骨骼规范,生成出来直接套在角色身上就能动!
3、成本直接被打骨折 角色、场景加十几套动作,在 PINOC 里一共只消耗了 100多积分。放以前找动捕棚或者外包动画师,光这些动作就得花上一大笔钱、等好几周!
其他环节顺手用 AI 一波流串起来: 道具丢给 Tripo,开场结局过场用即梦,配乐用 Suno,代码让 AI 编程助手写。
故事也很简单:巨大的蛾后卷走了星球上所有的光,小园丁要一路跳过五颗小星球,找回星种,让星球重新发芽。 五颗带微引力的小星球,绕着星球跑圈、下砸弹簧芽弹射起飞、滑铲钻杆、对着魔豆下砸长出通天藤蔓爬上去……类似马里奥银河的玩法几天就搓出来了。
PINOC 底层这个世界模型,厉害在它理解人在三维空间里是怎么动的,而不是一帧一帧去画图。
当 3D 资产和动作的门槛被彻底打穿,独立游戏真的要变天了,大家也快去试试 PINOC~
Kimi 回应额度消耗过快问题:非常抱歉,已经修复并重置月额度 25%
Kimi k3.1 发布时,大量订阅用户发现使用 Kimi 后额度消耗过快,套餐额度过少,向 Kimi 提出质疑
Kimi 回应称他们还调整了套餐的参数,并正在减少不必要的子代理调用和输出长度,以确保减缓配额消耗过快的问题
可是我总感觉这个问题的背后,更大的问题是 Kimi 的套餐配额太少了
你在用 Kimi 套餐吗,关于配额问题你怎么看?


We're sorry for the rate limits and unnecessary quota consumption on the K3.1 Pro subscription plan. These were our issues, and we should have fixed them sooner.
Today, every subscriber on every plan gets a one-time usage reset, restoring 25% of their monthly quota (usage below 25% resets to zero), equal to one week of usage. Your usage bar will reflect this adjustment by end of day PST.
We've also adjusted the plan's parameters and are reducing unnecessary subagent calls and output length, so your quota goes further.
Thank you for your patience while we put this right.


Thariq(@trq212)今天宣布离开 Anthropic
他在 Claude Code 团队待了一年多,看着这个产品从内部工具长成远超自己预期的规模。他在帖子里说,自己真心喜欢在这里工作,也相信公司的使命,尤其是那种 race to the top 的精神——大家认真做事、互相拉高标准,事情可以变得比想象中好得多
他评价同事是自己见过最优秀、最认真的一群人,并感谢 X 上的社区让这份工作既有趣也有压力。接下来他打算先休息一段时间,再开始新的事
很多人可能没关注过他这个人,但大概率看过他写的东西
他不只在做产品,还在持续把团队的实践拆开写给外面:
- 为什么在 Agent 时代 HTML 比 Markdown 更适合做计划与规格(信息密度、可视化、保持 HITL)
- 如何用 Claude Agent SDK 构建真正的 Agent(给模型一台计算机,而不是一堆孤立工具)
- Effort 档位到底控制什么、什么时候该用低档保持交互、什么时候该拉高做验证
- Skills 该怎么写才有用(别写显而易见的东西,重点记 gotchas,用文件系统做渐进披露)
还有上下文工程、工具设计、Artifacts 作为界面等一系列长帖
这些文章把内部评测、失败案例和真实工作流摊开了。很多现在大家默认的用法和理解,是他一篇篇写出来、被社区反复引用后才变成常识的。他相当于在产品之外,又做了一层高质量的开发者教程
关于离职的原因,他在推文中说道,是时候休息再出发
他说后面 Claude Code 的其他小伙伴也会继续分享实践心得经验,但 Thariq 的离开,意味着社区少了一个既懂技术实现、又愿意把复杂事情讲清楚的声音
无论如何,还是非常感谢 Thariq 这一年多的分享!跟 Thariq 学习受益良多,祝你接下来一切顺利!

I’ve left Anthropic after more than a year of working on Claude Code and seeing it scale larger than I ever imagined.
I have really loved working at Ant and believe deeply in the mission, and most of all, the idea of a race to the top.
The idea that if we work hard and responsibly, we can raise the bar and inspire others to great outcomes. And if we all push each other to be better, things can be radically good. I will carry the spirit of this with me forever.
My colleagues at Anthropic are the most talented, thoughtful, competent, and earnest people I have ever met. I am glad they are at the wheel and trust them deeply.
To the community on X, thank you for everything. You’ve made this the most fun (and sometimes stressful) job I’ve ever had.
For me, it is time for a bit of a break before diving into something new.
If you want more excellent Claude Code content, you should follow @addyosmani , @lydiahallie, @_catwu, @ClaudeDevs and of course @bcherny who started it all.
本来今天应该是属于 Kimi 的高光时刻,却因为额度太少大家被频频吐槽
咱就是说,这样下去以后中转掺假都得在 Kimi 里掺 Claude 了😢

Kimi K3.1 Pro 五个新套餐两个老套餐额度最新测算:(仅计算 K3.1 Pro)
Go: 49元,Token 额度:无kimi code 忽略
Plus:99元,月额度:73m,5H:3.48M,5H 换算 0.9 刀
倍率:1x
Pro: 199元,月额度:365m,5H:17.4M,5H 换算 4.3 刀
倍率:2x
Max: 699元,月额度:1169M,5H:55.7M,5H 换算 13.9 刀
倍率:5x
Max: 1399元,月额度:2338m,5H:111.3M,5H 换算 27.8 刀
倍率:10x
老Allegretto:199 元,月额度:703M,5H:34.8M,5H 换算 10 刀
倍率:4x
老Allegro:699 元,月额度:2191M,5H:104.3M,5H 换算 25 刀
实际倍率:10x

卧槽,全体起立!一觉醒来全球震惊瘫坐了!Kimi K3.1 正式发布!
国产大模型正式跻身全球大模型第一梯队!脚踢 Anthropic,拳打 OpenAI!
100 万 token 上下文,MOE,2.8T 总参数 / 1040 亿活跃参数,支持多模态
说实话兄弟们,我看完 Kimi 贴出来的跑分结果我都不敢相信,就连外国友人都说这个成绩难以置信!
Kimi K3.1 Pro 在9项上超过 Claude Opus 5.5,特别强的领域包括:
在 Terminal-Bench 4.0 终端交互任务上,Kimi K3.1 Pro 以 65.7 紧咬第一名的 Opus 5.5(66.4)
在更偏真实软件工程长程推理的 SWE Marathon中,Kimi K3.1 Pro 拿下了第一(51.7),领先 Opus 5.5(46.3)和 Fable 5.1(45.6)
在 Agents' Last Exam 中同样以 43.2 排名第一,超越 Opus 5.5 的 42.6
价格方面,K3.1 Pro 仅为上一代 K3 的 2/3
输入 $2 每百万 token,缓存输入 $0.2 每百万token,输出 $10 每百万token
同时推出高速版,
输入 $4 每百万 token,缓存输入 $0.2 每百万token,输出 $20 每百万token
让我们恭喜 Kimi 跻身全球大模型第一梯队🎉


